# Apache Flink + GreptimeDB:高效数据写入指南
Source: https://greptime.cn/blogs/2025-07-15-flink-greptimedb-data-ingestion-guide
> 💡 本篇文章所述需要在 GreptimeDB v0.15 前提下使用,请相关的用户尽快升级。
>
> 我们将在 v0.15 后发布一系列文章,已经发布的文章列表如下:
>
> [《GreptimeDB v0.15 重磅发布:Pipeline VRL 处理器与 Bulk 高吞吐写入》](https://greptime.cn/blogs/2025-07-08-greptimedb-new-version-release.html)
>
> [《精准定位慢查询:GreptimeDB v0.15 查询管理功能指南》](https://greptime.cn/blogs/2025-07-11-greptimedb-long-run-query.html)
>
> ......
>
> 其他文章更新中,敬请期待。
在当今大数据和物联网时代,**实时数据处理与分析能力**已成为现代应用的核心。
**Apache Flink** 作为**业界领先的流处理框架**,能为开发者带来端到端的实时计算能力;而 **GreptimeDB** 是一款**专为可观测数据场景打造的高性能、云原生数据库**。两者结合,便可构建强大而灵活的实时数据处理与存储分析平台。
 (图 1:Apache Flink)
本篇文章将深入探讨 GreptimeDB 在数据写入方面的特性,并聚焦于如何通过 Flink 将数据高效写入到 GreptimeDB。我们专门为此场景定制了 **Flink Sink——[GreptimeSink](https://github.com/GreptimeTeam/demo-scene/blob/main/flink-ingestion/flink-sink/src/main/java/io/greptime/demo/GreptimeSink.java)**,**为用户打造稳定、高效和易扩展的数据写入链路提供了可靠支撑**。
## 为什么选择 GreptimeDB 进行数据写入
在深入代码实现之前,首先思考一个核心问题:为什么 GreptimeDB 特别适合作为 Flink 的 Sink:
### 1. 高性能写入,列式存储设计
- **底层架构**:GreptimeDB 底层采用类似 **LSM-Tree** 的存储架构,结合列式存储。这种设计极大地**优化了写入吞吐量**,能够轻松应对高并发的数据流。
- **写入流程**:数据先被写入内存中的 MemTable,然后合并、批量刷写到持久化的存储层,**避免了昂贵的随机写操作**。
### 2. 云原生的分布式架构与水平扩展能力
- **架构特点**:采用**云原生架构**,计算(Datanode)与存储(如 S3 等共享存储)解耦,节点扩缩灵活,**与 Flink 的弹性伸缩特性完美匹配**,能够达到资源利用最大化。
- **动态伸缩**:Flink 的 TaskManager 可根据负载动态调整并行度,而 GreptimeDB 的计算层(Datanode)也能通过 Kubernetes 快速扩缩容,**避免传统数据库因存储绑定计算导致的写入瓶颈**。
### 3. 原生 gRPC 接口
- **通信协议**:**原生支持 gRPC**,接口异步、非阻塞,天然适配 Flink 的流式分布式特性。
- **高效批量接口**:**支持批量与流式写入**,最大化数据管道效率,降低网络开销。
## 实战解析:GreptimeSink 实现
要将 Flink DataStream 的数据高效写入 GreptimeDB,需实现自定义 Sink。核心任务是对接数据库(GreptimeDB)客户端、配置表结构,并创建一个 `SinkWriter` 来实现批量高效的写入逻辑。
> 完整代码已开源,请访问[仓库](https://github.com/GreptimeTeam/demo-scene/tree/main/flink-ingestion/flink-sink)获取。
>
> 另外,在这个[仓库](https://github.com/GreptimeTeam/demo-scene/tree/main/flink-ingestion)中做了一个 Demo:用 Flink 解析 Nginx access log 并存入 GreptimeDB(如下所示),可以用 Docker Compose 一键拉起,欢迎尝试👏
### GreptimeSink 实现核心
首先看一下 [GreptimeSink](https://github.com/GreptimeTeam/demo-scene/blob/main/flink-ingestion/flink-sink/src/main/java/io/greptime/demo/GreptimeSink.java) 的实现:
```java
class GreptimeSink implements Sink {
@Override
public SinkWriter createWriter(WriterInitContext context) {
// 1. 初始化 GreptimeDB 客户端
GreptimeDB greptimeDb = GreptimeDB.create(GreptimeOptions.newBuilder(endpoint, "public").build());
// 2. 定义表结构 (Schema)
TableSchema tableSchema = TableSchema.newBuilder("my-table")
.addTimestamp("timestamp", DataType.TimestampMillisecond) // 时间戳索引列
.addField("f1", DataType.String)
// ...其他列
.addField("fn", DataType.String)
.build();
// 3. 创建并返回一个 GreptimeSinkWriter 实例
// 使用 bulkStreamWriter 以支持高效的批量流式写入
returnnew GreptimeSinkWriter(greptimeDb.bulkStreamWriter(tableSchema));
}
}
```
**核心要点**:`createWriter` 方法负责实例化一个 `BulkStreamWriter` ——专为批量/流式写入优化的组件。与传统逐行写入相比,它能够**明显提升吞吐量,降低资源消耗**。
### 写入执行者:`GreptimeSinkWriter`
[`GreptimeSinkWriter`](https://github.com/GreptimeTeam/demo-scene/blob/main/flink-ingestion/flink-sink/src/main/java/io/greptime/demo/GreptimeSinkWriter.java) 实现缓存与批量写入策略,将 Flink 流中的每条数据缓存起来,并**在合适的时机批量写入 GreptimeDB**。
```java
class GreptimeSinkWriter implements SinkWriter {
// 定义每个批次的最大行数
privatestaticfinalint MAX_ACCUMULATED_ROWS = 1_000;
privatefinal BulkStreamWriter writer;
// 本地缓存
private Table.TableBufferRoot buffer;
// 已缓存的行数
privateint accumulated_rows = 0;
GreptimeSinkWriter(BulkStreamWriter writer) {
this.writer = writer;
this.buffer = createRowBuffer();
}
// 创建一个新的行缓冲区
Table.TableBufferRoot createRowBuffer() {
return writer.tableBufferRoot(MAX_ACCUMULATED_ROWS);
}
@Override
public void write(String input, Context context) {
// 将原始字符串输入解析为结构化数据行
Object[] row = parse(input);
buffer.addRow(row);
// 当累积的行数达到阈值时,触发写入操作
if (++accumulated_rows >= MAX_ACCUMULATED_ROWS) {
bulk_insert();
}
}
// 在 Flink checkpoint 或任务结束时,确保将缓冲区剩余数据写入
@Override
public void flush(boolean endOfInput) {
if (accumulated_rows == 0) {
return;
}
bulk_insert();
}
void bulk_insert() {
// 标记缓冲区已完成,准备发送
buffer.complete();
// 异步写入数据
CompletableFuture future = writer.writeNext();
// 等待并获取写入的行数
Integer rows = future.get();
// 重置缓冲区和计数器,为下一个批次做准备
buffer = createRowBuffer();
accumulated_rows = 0;
}
}
```
#### 关键机制解读
**1. 缓冲机制**
- `MAX_ACCUMULATED_ROWS` 是一个可调参数,能够定义每个批次的大小,可根据写入压力、时延要求**自适应调整**;
- `write()` 方法是数据的入口。每条数据经过解析后,不会立即发送,而是通过 buffer.addRow() 添加到内存缓冲区中;
- 当缓冲区中的数据量达到 `MAX_ACCUMULATED_ROWS` 阈值时,系统会调用 `bulk_insert()` 方法执行真正的写入。
**2. 批量写入(`bulk_nsert` 方法)**
- `buffer.complete()`: 锁定当前缓冲区,准备好被发送;
- `writer.writeNext()`: `BulkStreamWriter`的核心方法。它将整个缓冲区的数据作为一个批次,通过 gRPC Stream 异步发送到 GreptimeDB。这种方法避免了为每一行数据都建立一次网络连接,**极大地提高了写入效率**;
- `future.get()`: `writeNext()` 返回一个 `CompletableFuture`,允许进行异步操作,此时选择简单地阻塞等待写入完成。用户可以根据实际需要将这个 `future` 进行其他异步操作,例如使用 `thenApply/thenAccept` 进行回调;
- **重置缓冲区**:写入完成后,必须创建一个新的缓冲区并重置计数器,为下一个批次做准备。
**3. 数据不丢失(`flush` 方法)**
- Flink 在执行 Checkpoint 或数据流结束时会调用 `flush()` 方法;
- 这个方法确保了**即使缓冲区没有满**,其中**缓存的数据也能被及时写入数据库**,从而防止了数据丢失。这是一个健壮的 Sink 必须具备的特性。
## 典型应用场景
Flink + GreptimeDB 的高效写入链路在以下典型场景的数据写入分析中表现尤为突出:
### 1. 日志分析管道
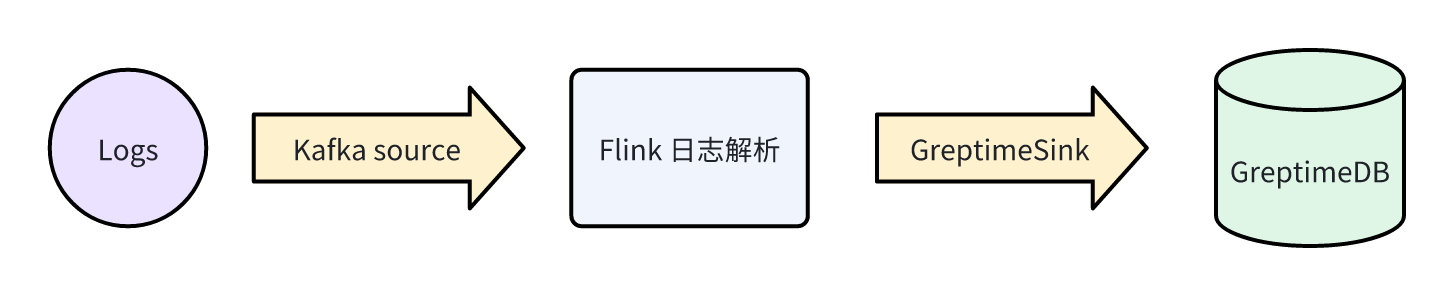 (图 2:日志分析管道)
适合处理**高并发、大体量的非结构化日志数据**,自动转换为结构化表存储,助力实时监控与审计。
### 2. 实时指标采集与分析
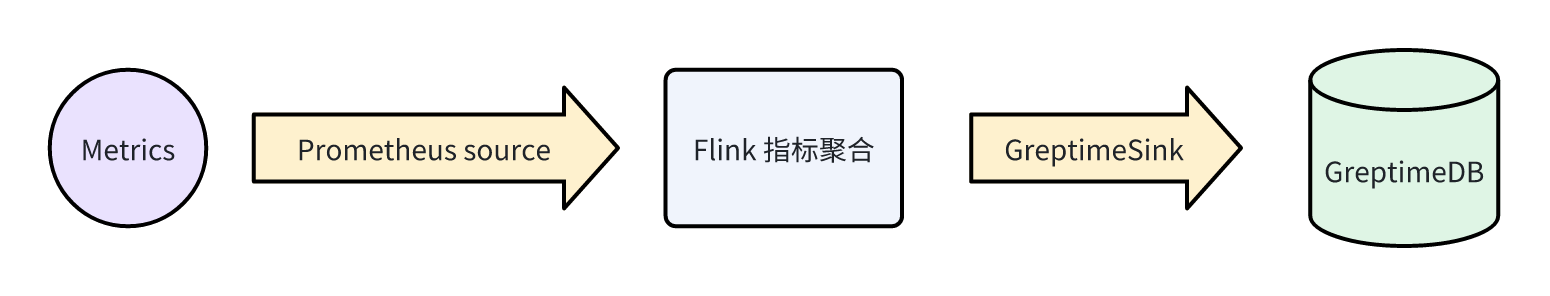 (图 3:实时指标采集与分析)
**秒级事件聚合、低时延写入**,适用于应用性能监控、业务看板等场景,确保 Metrics 数据的精度与实时性。
3. 物联网(IoT)数据处理
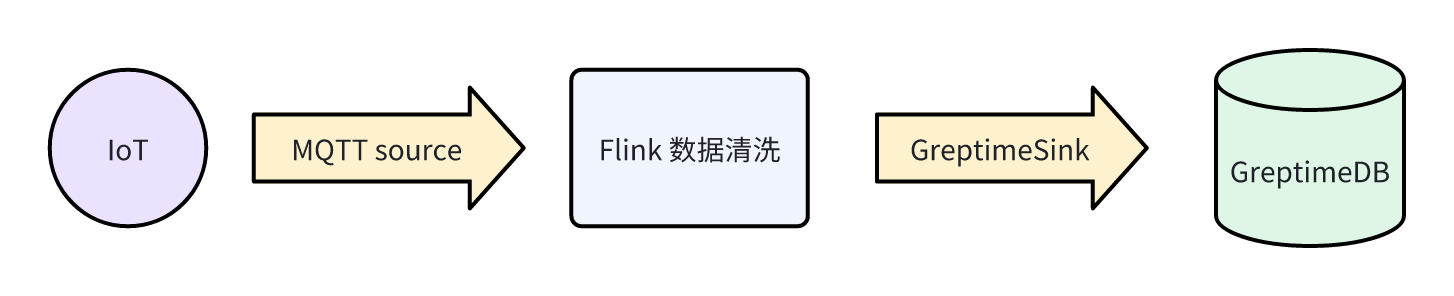 (图 4:实时指标采集与分析)
可应对**大规模设备高频写入**,配合自定义规则引擎超快触发实时告警,助力智能运维和工业监护。
## 总结
通过 Flink 将数据写入 GreptimeDB 的过程可以非常高效和可靠。本文介绍的 `GreptimeSink` 实现方法,其核心优势在于充分利用了 GreptimeDB Java SDK 提供的 `BulkStreamWriter`。
### 关键要点回顾
- **批处理是性能关键**:采用批量写入(Buffering + Batch Insert)的策略实现高吞吐,摒弃逐条写入的低效做法;
- **`BulkStreamWriter` 极致优化**:对流式高并发场景适配良好,简化开发、提升吞吐;
- **健壮性设计**:正确实现 Flush 逻辑,与 Flink 的 Checkpoint 机制相结合,确保数据在任何情况下都不会丢失。
将 Flink 强大的流计算与 GreptimeDB 的高性能时序存储结合,能够**为监控、IoT、实时分析等多类业务构建现代化实时数据平台**。
欢迎访问 [flink-demo 仓库](https://github.com/GreptimeTeam/demo-scene/tree/main/flink-ingestion/flink-sink) 获取完整代码,实现属于你自己的高效 Flink+GreptimeDB 数据管道!