# 「用户案例」阿里云 InfluxDB 退市在即:573 个 shard 迁移至 GreptimeDB 实录
Source: https://greptime.cn/blogs/2026-08-20-aliyun-influxdb-to-greptimedb-migration
## 前言
阿里云 InfluxDB 托管服务将于 2026 年 10 月 23 日[退市](https://help.aliyun.com/zh/document_detail/2931902.html),对还在使用的业务来说,迁移已经是必须排期的事。
本文记录一次从阿里云 InfluxDB 到 [GreptimeDB 企业版](https://greptime.cn/product/enterprise)的完整迁移实践:借助 influxd backup / influxd restore / influx_inspect export 与 GreptimeDB 的 InfluxDB 写入协议,按 shard 中继搬迁,完成 2 年多、6 个库、573 个 shard 的数据迁移。
## 背景
明德盛元面向零碳工厂、园区、商业综合体等场景,通过光储充、分布式发电、地热余热回收等技术,将绿电、绿热、节能减排、双碳管理及虚拟电厂统一规划建设运营,为行业客户提供零碳园区整体解决方案。
其核心平台长期运行在阿里云上,使用阿里云时序数据库 InfluxDB 版(InfluxDB 1.x 兼容)作为时序数据的存储底座,采集和存储来自设备、EMS 等业务系统的监控与运行数据。
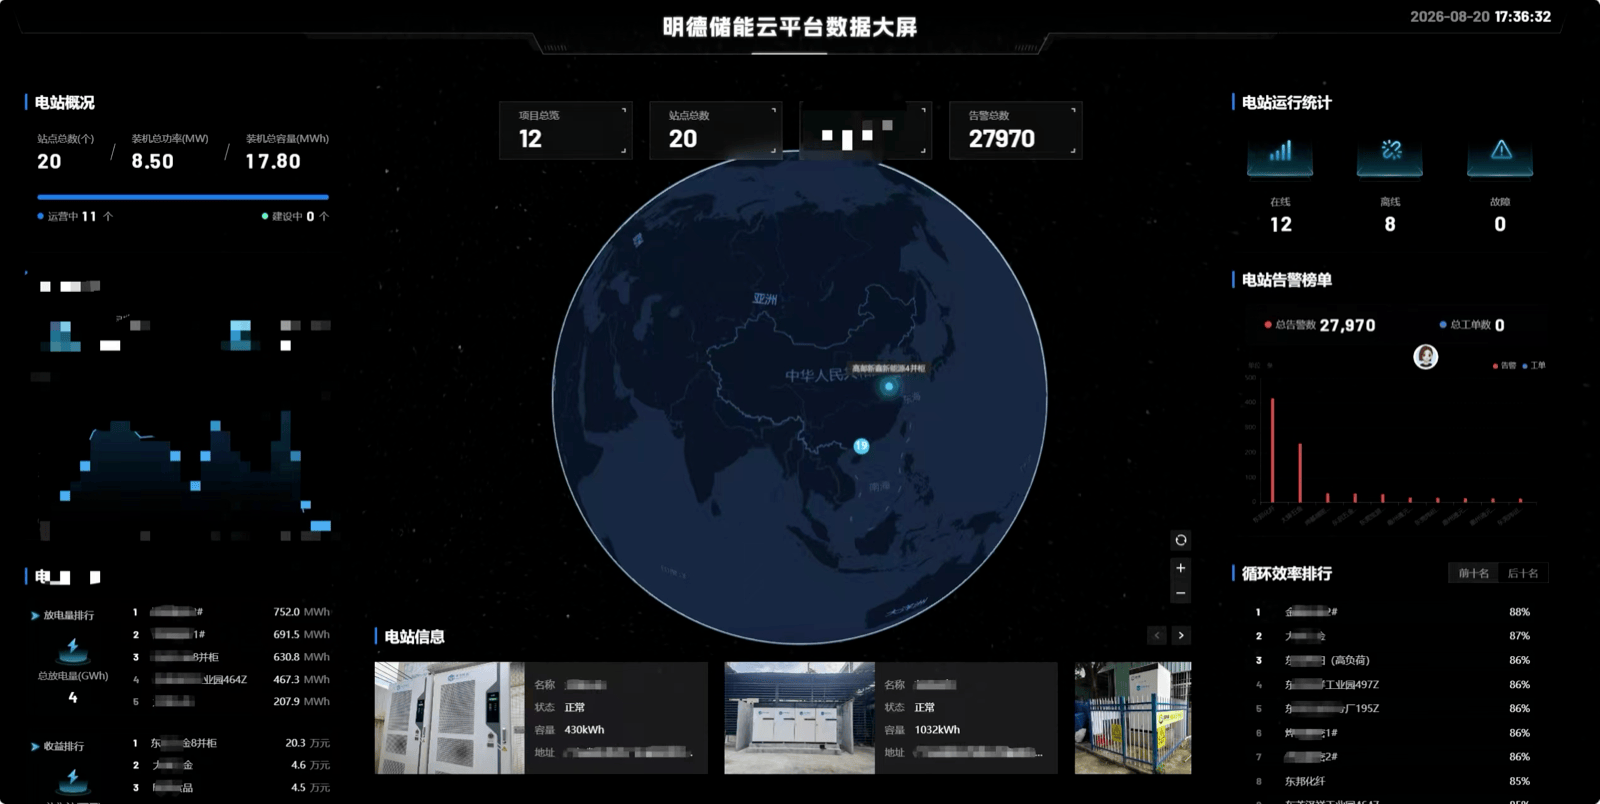
储能云平台数据大屏:站点、装机容量、告警与循环效率的实时汇总
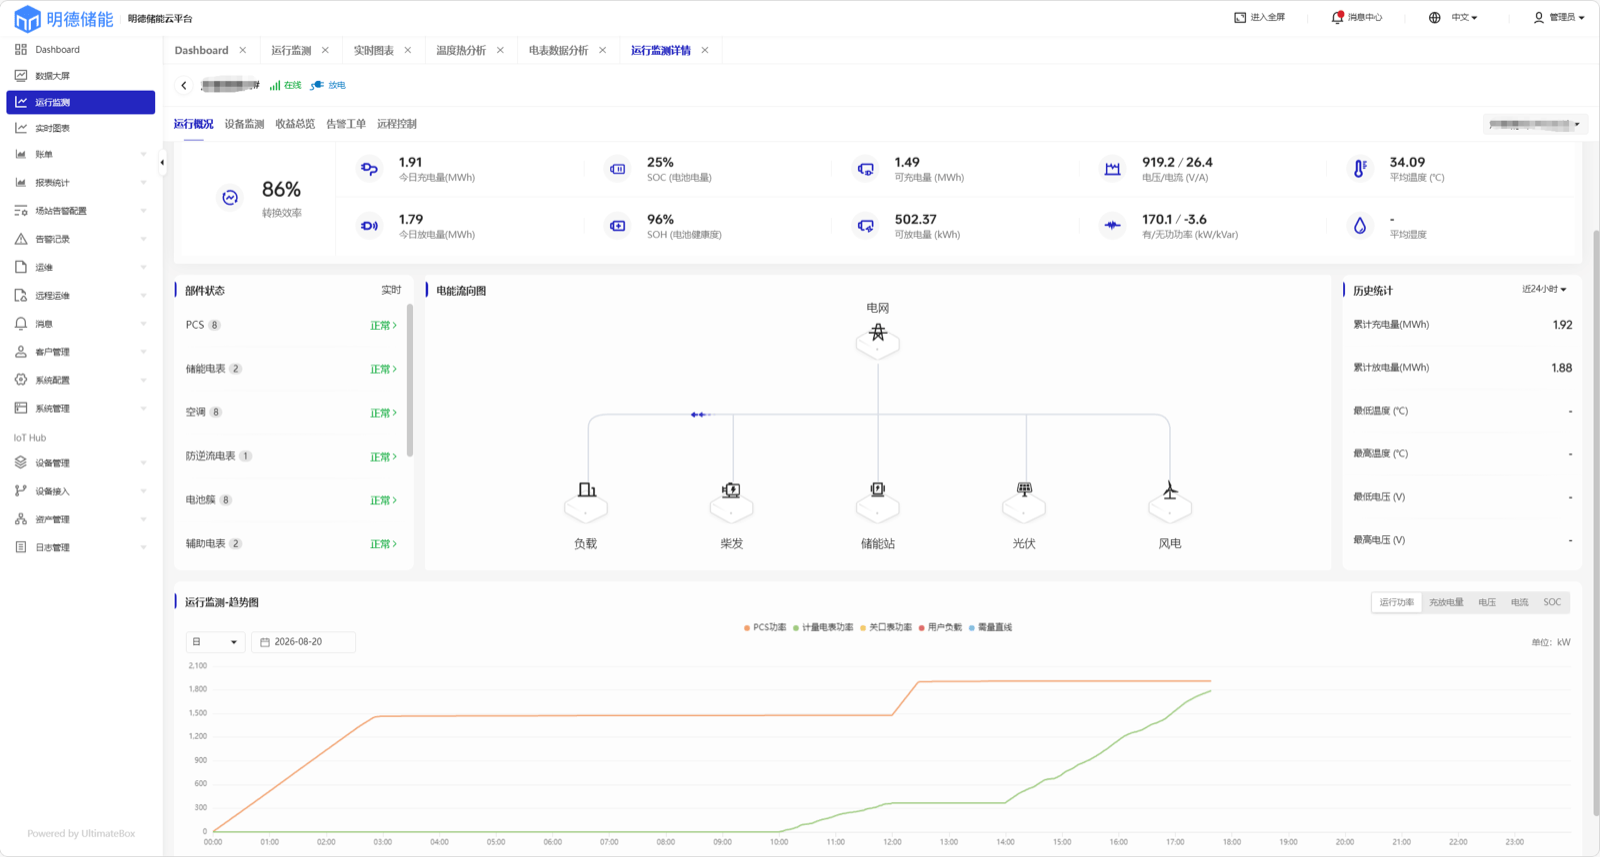
单站点运行监测:充放电量、SOC/SOH、电能流向与近 24 小时趋势
平台整体架构如下,时序数据的存储位于「数据存储」层:
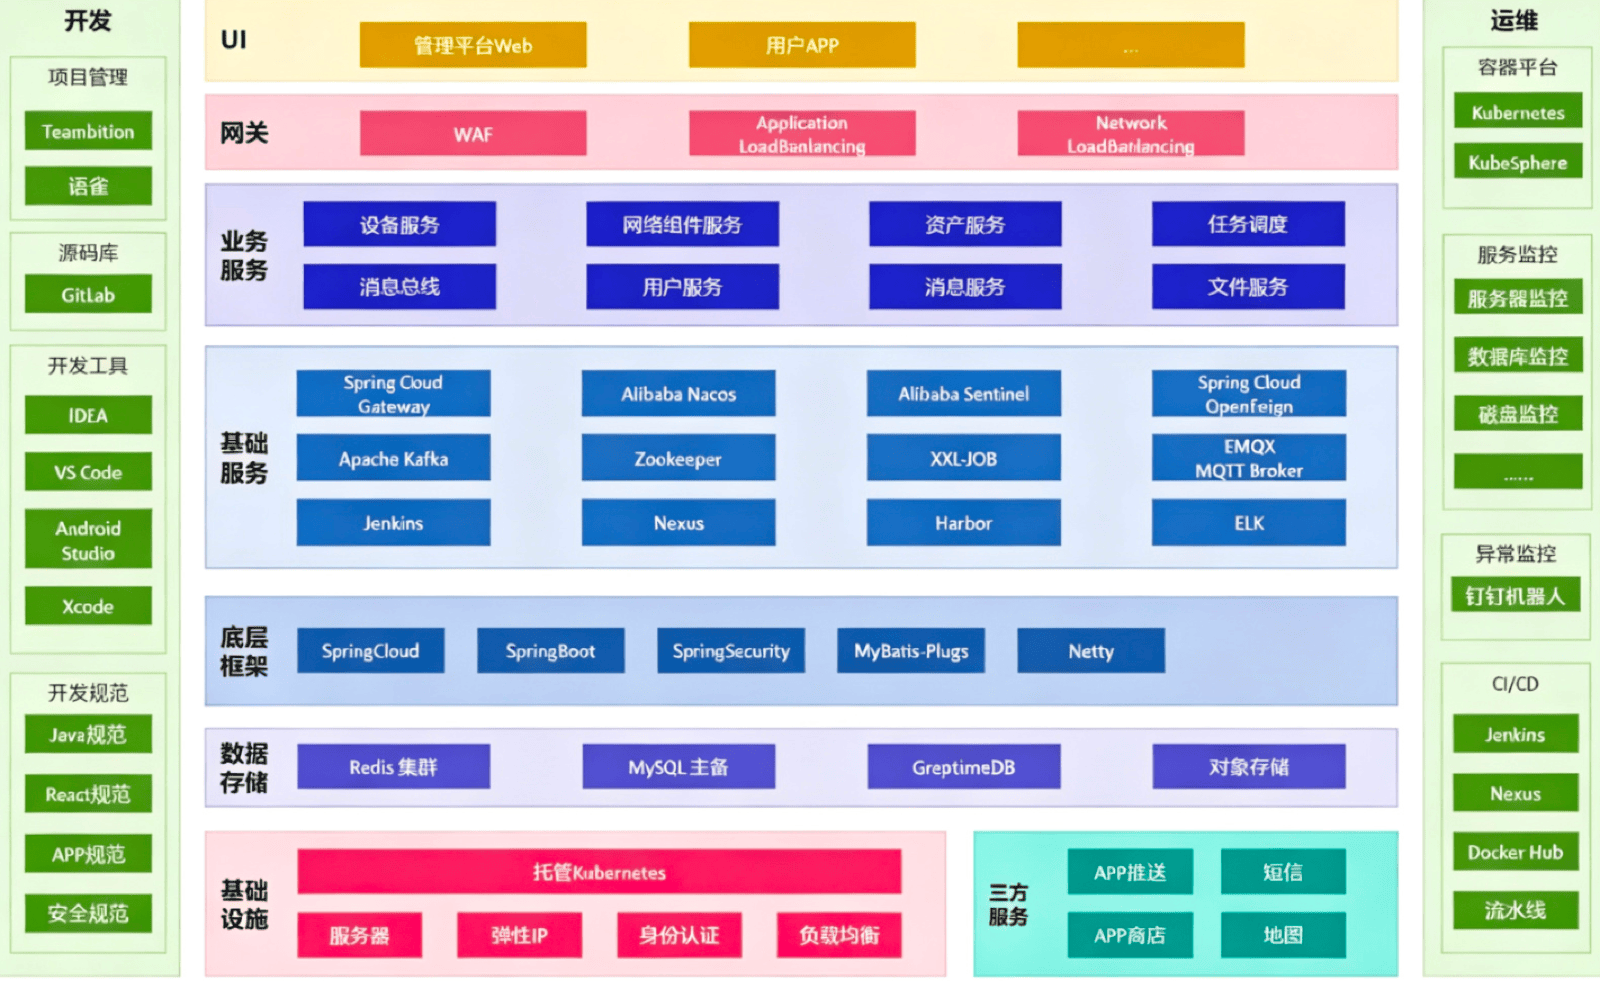
平台技术架构,时序底座迁移后由 GreptimeDB 承接
经过两年多的运行,这套 InfluxDB 集群的规模是:
- **6 个数据库**:`db-1`、`db-2`、`db-3`、`db-4`、`db-5`、`db-6`;
- **573 个 shard**,覆盖 2024 年 6 月至 2026 年 8 月约 2 年 2 个月的数据;
- 按周做数据分片(shard group),统一使用默认保留策略 `autogen`。
随着数据量与查询需求的持续增长,团队开始评估将时序底座从托管 InfluxDB 迁往一个更开放、查询能力更强、成本更可控的方案,最终选定了 GreptimeDB。
## 为什么要离开阿里云 InfluxDB
阿里云 InfluxDB 作为托管服务,胜在部署简单、免运维。但在生产环境跑了两年后,几个问题逐渐暴露出来:
- **产品退市**:2026 年 10 月 23 日之后,阿里云 InfluxDB 不再提供服务和技术支持。
- **查询能力受限**:InfluxQL 的表达能力有限,复杂的关联分析、聚合与二次计算要么写不出来,要么需要把数据搬出去处理;
- **托管服务的黑盒限制**:无法直接访问底层数据文件,也无法使用 `influx_inspect` 等工具对数据做本地化处理;
- **成本随规模线性增长**:随着 shard 数量与数据量上升,实例与存储成本持续增加,且缺少压缩与生命周期管理的精细手段;
- **演进受限**:托管 InfluxDB 版本与能力由云厂商决定,团队无法自主升级、扩展或引入新的索引与查询能力。
GreptimeDB 提供了[标准 SQL 查询](https://docs.greptime.cn/user-guide/ingest-data/for-iot/sql/)、列式存储与高压缩率、存算分离架构,同时原生兼容 InfluxDB 写入协议。这意味着迁移后,既有写入链路的改动可以降到最低,查询与存储能力也能同步升级。
## 迁移难点:托管服务只给了备份这一条路
迁移的第一步,是搞清楚数据怎么拿出来。这里有一个关键约束:
> 阿里云 InfluxDB 是托管服务,用户无法直接接触到底层的 TSM 数据文件,也没有 `influx_inspect` 可用。**唯一稳定可靠的取数途径,就是 `influxd backup -portable` 备份接口。**
但紧接着第二个问题来了:`influxd backup` 产出的是 InfluxDB 自己的可移植备份格式(元数据 + TSM 数据文件),GreptimeDB 并不能直接导入这种格式。GreptimeDB 能直接吃的是 **InfluxDB Line Protocol(行协议)**。
于是,整个迁移方案的关键设计就明确了——**引入一台自建 InfluxDB 作为中继站**:
```text
阿里云 InfluxDB ──(influxd backup)──> 备份文件
│
└──(influxd restore)──> 自建 InfluxDB(中继)
│
(influx_inspect export -lponly)
│
▼
Line Protocol 文件
│
(写入 GreptimeDB)
▼
GreptimeDB 企业版
```
同时,考虑到数据量较大(2 年多、上百个 shard),团队没有选择整库一次性搬迁,而是**按 shard 逐个迁移**。这样做有几个好处:
- 单次操作的数据量可控,内存和磁盘占用有界;
- 单个 shard 失败不影响整体进度,可以重跑;
- 迁移进度可观测;
- 后续还可以按 shard 并行加速。
## 迁移方案:四步中继搬迁
下面以 `db-1` 库为例,展示单个 shard 的完整迁移流程。整个流程由四步组成。
### 第一步:从阿里云备份 shard
```bash
influxd backup -portable \
-host ${InfluxDB_IP}:8088 \
-db db-1 \
-rp autogen \
-shard 1 \
/data/backup/shard_1
```
- `-portable`:生成可移植备份格式,便于跨环境恢复;
- `-host`:阿里云 InfluxDB 实例的备份地址(默认 8088 端口);
- `-db` / `-rp` / `-shard`:把备份范围精确限定到单个 shard,避免整库备份。
### 第二步:恢复到自建 InfluxDB
```bash
influxd restore -portable \
-db db-1 \
-rp autogen \
-shard 1 \
-newdb db-1 \
/data/backup/shard_1
```
在自建的 InfluxDB 1.x 实例上执行恢复。这台自建实例就是中继站,`-db` 是备份文件里的源库名,`-newdb` 指定恢复后的目标库名。
### 第三步:导出自建 InfluxDB 数据
```bash
influx_inspect export -database db-1 -lponly -datadir ${InfluxDB_Data_Directory} -waldir ${InfluxDB_WAL_Directory} -out /data/export_data/shard_1
```
这一步把 TSM 数据文件转换成人类可读的 **InfluxDB Line Protocol** 文本。这里有两点值得注意:
- **`-lponly` 一定要加**:它表示只导出 line protocol,不导出 DDL 元数据。如果不加,导出的文件里会混入建库建表语句,后续写入 GreptimeDB 时会报错;
- **恢复后要稍等片刻再导出**:restore 完成后,数据可能还留在 WAL 中尚未完全落盘。等十几秒到几十秒再执行 export,能避免漏数据。
### 第四步:导入 GreptimeDB
```bash
export GREPTIME_USERNAME=
export GREPTIME_PASSWORD=
export GREPTIME_HOST=
export GREPTIME_DB=
for file in /data/export_data/shard*; do
curl -i --retry 3 \
-X POST "http://${GREPTIME_HOST}:4000/v1/influxdb/write?db=${GREPTIME_DB}&u=${GREPTIME_USERNAME}&p=${GREPTIME_PASSWORD}" \
--data-binary @"${file}"
sleep 1
done
```
GreptimeDB 原生支持 InfluxDB 写入协议,v1 写入端点 `/v1/influxdb/write` 位于 HTTP 端口 4000 上,通过 `db`、`u`、`p` 三个查询参数即可指定数据库并传入认证信息(注意:`u`/`p` 放在 URL 查询参数中可能会被代理/访问日志记录;生产环境建议使用 HTTPS,并尽量避免在共享环境中暴露凭据)。Line Protocol 中的 measurement 会自动映射为 GreptimeDB 的表,tag 映射为标签列,field 映射为字段列,时间戳映射为时间索引,无需额外转换。
本文只覆盖了这次迁移实际走的路径。官方文档[从 InfluxDB 迁移至 GreptimeDB](https://docs.greptime.cn/user-guide/migrate-to-greptimedb/migrate-from-influxdb/) 还介绍了 v2 行协议端点、Telegraf 与各语言客户端库的写法,以及 InfluxQL 到 SQL / PromQL 的查询改写,做迁移评估时可以一并参考。
## 批量编排与可恢复性
单个 shard 的四步流程,被封装进一个批量迁移脚本,按 shard 列表逐个循环执行,每一步都落日志、判失败,并在单个 shard 处理完成后清理自建库,避免中继站数据堆积。
这里真正考验人的,其实是**shard 列表怎么确定**。如果简单地认为 shard ID 是连续的,就会踩坑。以 **db-1** 库为例,有 111 个 shard ID,实际分成三段:
| 分段 | shard ID 范围 | 数量 | 说明 |
| ------ | ------------------------------------------- | ---- | ------------------------------------------------------------ |
| 连续段 | 85–126 | 42 | 早期(2024-06 ~ 2025-05),业务库较少,ID 连续 |
| 散列段 | 129、177、183、188、195、201、206、211、216 | 9 | 过渡期(2025 年中),其他库陆续接入,ID 开始交错 |
| 步进段 | 222–576,步进 6 | 60 | 稳定期(2025-06 之后),6 个库共享全局序列,单库 ID 呈步进 6 |
总量正好是 111 个。这个步进 6 的由来,是**多个数据库共享同一个全局递增的 shard ID 序列**:每个周分片,6 个库各分到一个连续的 shard ID,于是对单个库来说,相邻两个 shard 的 ID 就相差 6。因此,迁移前一定要先导出并分析 shard 结果,把实际存在的 shard 列表理清楚,而不是想当然地做连续枚举。
## 踩坑与经验
- **先摸清 shard 分布,再动手迁移**:多库共享全局 shard ID 序列,导致单个库的 shard ID 不连续、存在跳号。迁移前用 `show shards` 导出完整清单并做分析,是避免漏迁、错迁的第一步。
- **警惕脏数据 shard**:在 `show shards` 分析中发现库中存在一个 start_time 为 `1969-12-29` 的异常 shard,疑似时间戳写入异常。这类 shard 需要在迁移前后单独核对数据完整性。
- **restore 之后要等待 WAL 落盘**:恢复到自建库后立即 export,可能因为数据还停留在 WAL 里而漏数据,等上十几秒到几十秒更稳妥。
- **`-lponly` 不可省略**:只导出 line protocol、跳过 DDL,才能让导出的文件干净地写入 GreptimeDB。
- **导入要限流 + 重试**:`--retry 3` 与 `sleep 1` 的组合,能有效规避瞬时失败与写入反压。
- **单个 shard 处理完就清理中继库**:及时 `drop database`,防止自建 InfluxDB 的数据目录越积越大。
## 效果与收益
通过这套按 shard 中继搬迁方案,客户把 2 年多、6 个库、573 个 shard 的时序数据从阿里云 InfluxDB 完整迁入了 GreptimeDB 企业版:
- **数据无损、过程可控**:按 shard 迁移 + 逐步校验,迁移过程可观测、可续传,单个失败不影响整体;
- **写入链路改动最小**:GreptimeDB 兼容 InfluxDB 写入协议,原有数据采集与写入端的改造量很低;
- **查询能力升级**:从 InfluxQL 切换到标准 SQL,复杂分析、关联与聚合的表达能力大幅提升,同时可借助 [greptimedb-mcp-server](https://github.com/GreptimeTeam/greptimedb-mcp-server) 提供的 MCP(Model Context Protocol)能力,让 AI 助手直接连接 GreptimeDB 进行数据取数与分析,进一步降低使用门槛;
- **存储成本可控**:GreptimeDB 的列式存储与高压缩率,配合企业版的 TTL 生命周期管理与对象存储分层,为持续增长的数据量留出了成本空间;
- **运维更省心**:GreptimeDB 企业版提供高性能写入、主备双活、监控告警与专家支持,让团队不必再受托管黑盒的限制。
## 总结
本文通过自建 InfluxDB 中继 + 按 shard 迁移的方式,把阿里云 InfluxDB 数据转成 line protocol 后迁入 GreptimeDB。这套方案不依赖任何黑科技,全部建立在 InfluxDB 与 GreptimeDB 原生能力之上,就能解决托管服务的迁移难题。
阿里云 InfluxDB 将于 2026 年 10 月 23 日退市,Amazon Timestream for LiveAnalytics 也已自 2025 年 6 月起对新客户关闭。国内外都有不少团队正在面临同样的迁移问题。GreptimeDB 兼容 InfluxDB 写入协议,同时支持标准 SQL 查询,已经承接了一批这样的迁移。如果你也在做类似的评估,欢迎与我们[联系](https://greptime.cn/contactus),或添加微信小助手:greptime。