本页内容

《可观测性已经开始统一,但查询它的不再只是人》的结尾我们留了一个问题:当 Agent 成为遥测数据的主要消费者,数据库本身要不要变。这篇是我们的回答,也是一次定义的尝试。
我们把 GreptimeDB 首页的定位改成了「The open-source observability database」。
这个名字目前没有多少市场基础。Gartner 有 Observability Platforms,没有 Observability Database。ClickHouse 把 ClickStack 称为 observability stack,Apache Doris 把 observability 放在 use case 里,Grafana、Datadog、Honeycomb 卖的都是 platform。就连 ClickHouse 这样最有资格强调数据库内核的公司,也只说 database 是 observability platform 的核心部件,没有把观测产品直接叫作 observability database[1]。
我们主动选择了一个分析师不覆盖、友商也没有共同使用的定位。
但是,我们不是为了造一个新词。相反,我们需要这个词来约束产品——或者流行的说法叫「定位」:GreptimeDB 只为遥测(可观测性)数据服务,数据库内核要理解这些数据的含义,并据此决定怎么存、怎么建索引、怎么查、怎么扩展(scale)。少了其中任何一条,「observability」都只是 database 后面附带的 use case。
可观测性数据库是什么
我对 Observability Database 的定义是:
一个为 metrics、logs、traces、wide events 等遥测数据提供统一存储和查询的数据库。它理解数据中的语义,据此优化存储、查询执行和扩展方式,并支持实时语义查询与跨信号关联。
它至少要在四个层面提供统一的使用体验。
第一,逻辑数据模型统一。在可观测性数据库的逻辑模型里,metrics、logs、traces、wide events,以及以后可能进入生产的 profiles,都应当表现为表(Table)。它们共用 schema、类型系统、时间索引和标签体系。跨信号关联可以写成普通 SQL,而不需要由 UI 发起几次独立查询再拼结果。
这里说的 wide event,指一条很宽的、带时间戳的事件记录。它在 GreptimeDB 里不是一种独立的信号类型,就是一张列很多的表。
第二,存储格式统一。数据以列式格式保存,不让使用者为不同信号维护完全不同的压缩、索引和成本模型。
第三,存储介质统一。对象存储承担主要留存,本地盘和内存处理热数据与缓存。存储容量和计算可以分开扩展,留存策略也不必按信号拆成三套。
第四,查询引擎统一。SQL 处理探索性分析和跨表关系,PromQL 继续服务指标查询。PromQL 最终也会转换成逻辑查询计划,和 SQL 一样交给 GreptimeDB 的查询引擎优化、生成物理计划并执行,不需要另存一份 PromQL 专用数据。PromQL 因此也有 TQL EXPLAIN 和 TQL ANALYZE,可以查看查询计划和运行时指标[2]。
请注意,这四点描述的是使用者看到的系统,但是并不意味着底层只有一种物理设计。
现在的栈把数据分开,也把问题分开了
可观测性长期「借用」了几类已有数据库。指标长得像时间序列,于是进入 TSDB;日志长得像文档,于是进入 Elasticsearch;后来列式数据库更便宜,日志又开始进入 ClickHouse 和 Doris;trace 通常再配一套后端,例如 Tempo。
这些选择分别看都合理。放在一起,系统之间的对接就落在监控研发和运维团队身上。
同一个请求的指标、日志和 span 被写进不同系统。trace_id 可能存三份,pod 名在三个 schema 里可能分别叫 pod、pod_name 和 k8s.pod.name。Grafana 的 cross-store correlation 能省掉复制粘贴,但它的执行机制仍然是带变量的链接:先查一个数据源,再把字段填进另一个数据源的查询模板,底层仍是不同系统里的独立查询[3]。
这类架构当然能工作,事实上大量生产系统都这么跑。问题出在一个问题需要跨系统回答的时候。一次查询要同时解释 label、采样比例和实体身份,还要把几个系统的时间范围对齐。每多跨一个系统,就多一次查询、一次结果搬运、一次语义对齐和一次时间对齐。
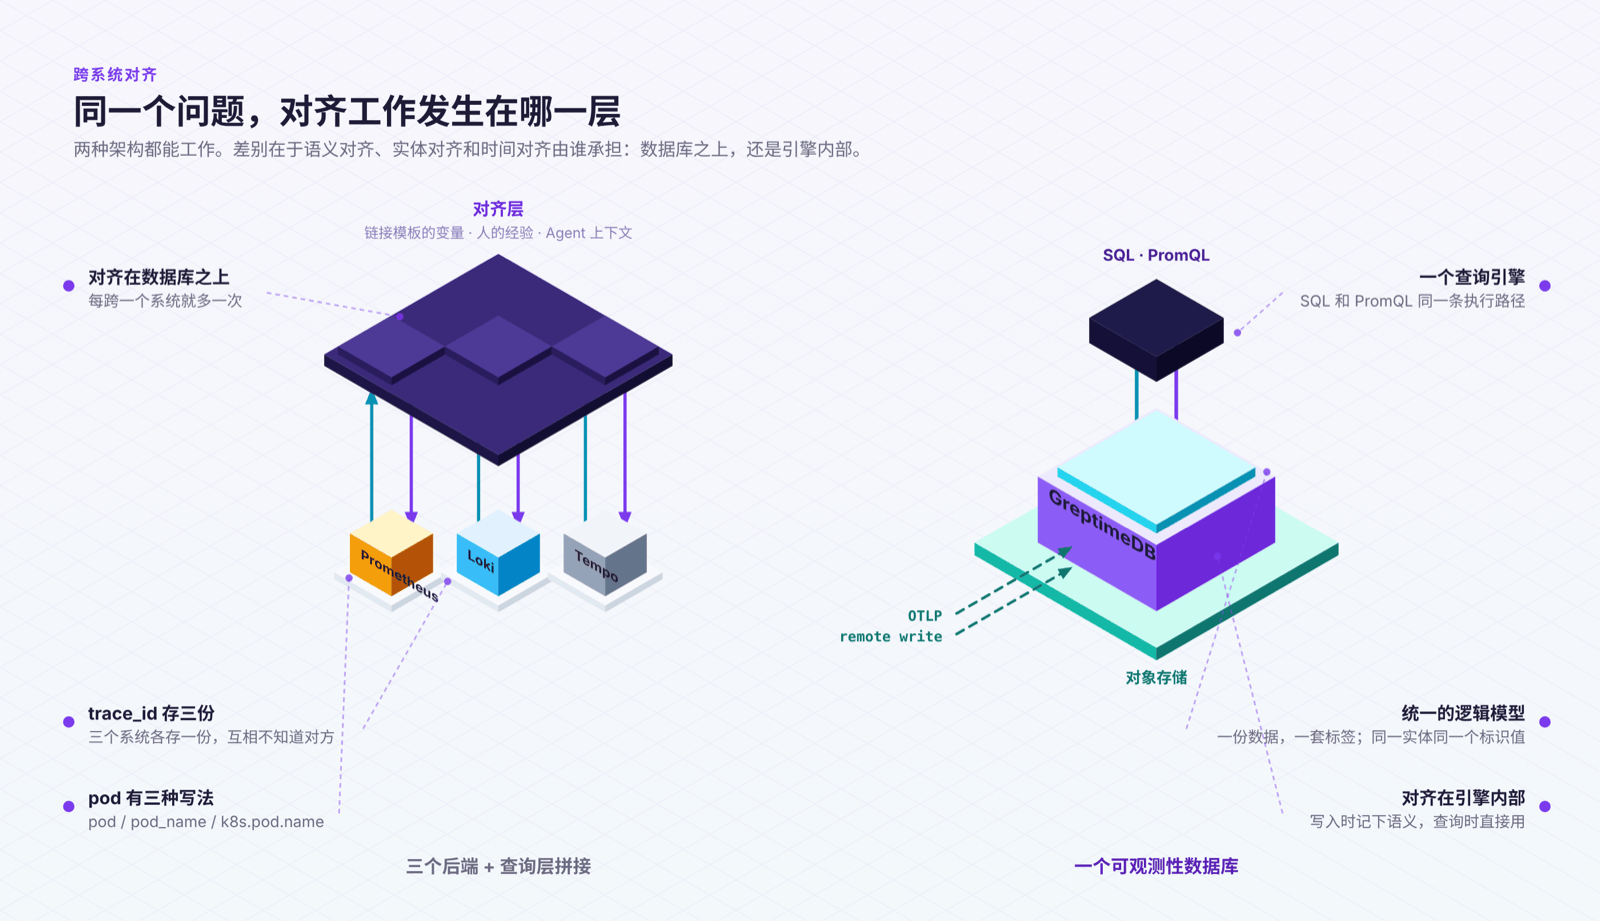
人靠经验还能补上很多缺口。Agent 会把这些代价放大。人的排查速度受限于能看多少图、能写多少查询。Agent 可以同时探索大量假设,查询形状也更难预测。把数据库藏在所谓的 AI front door 后面,不会让物理限制消失。点查仍然要读数据,join 仍然消耗内存,跨源关联仍然要付出网络往返。
为了衡量这些代价,我们做了一个 benchmark,固定模型和 prompt,只换查询接口:一边是 Prometheus、Loki、Tempo 三个后端的原生 API,一边是 GreptimeDB 上的只读 SQL 和 PromQL。六个模型、14 个 incident、504 次端到端排查。统一接口这一侧读入的 token 少约 48%,模型 API 成本低约 45%;这两项在六个模型上的结果是一致的,其中三个通过了 Holm 校正。正确诊断是统一接口 130、三个后端 105[4]。
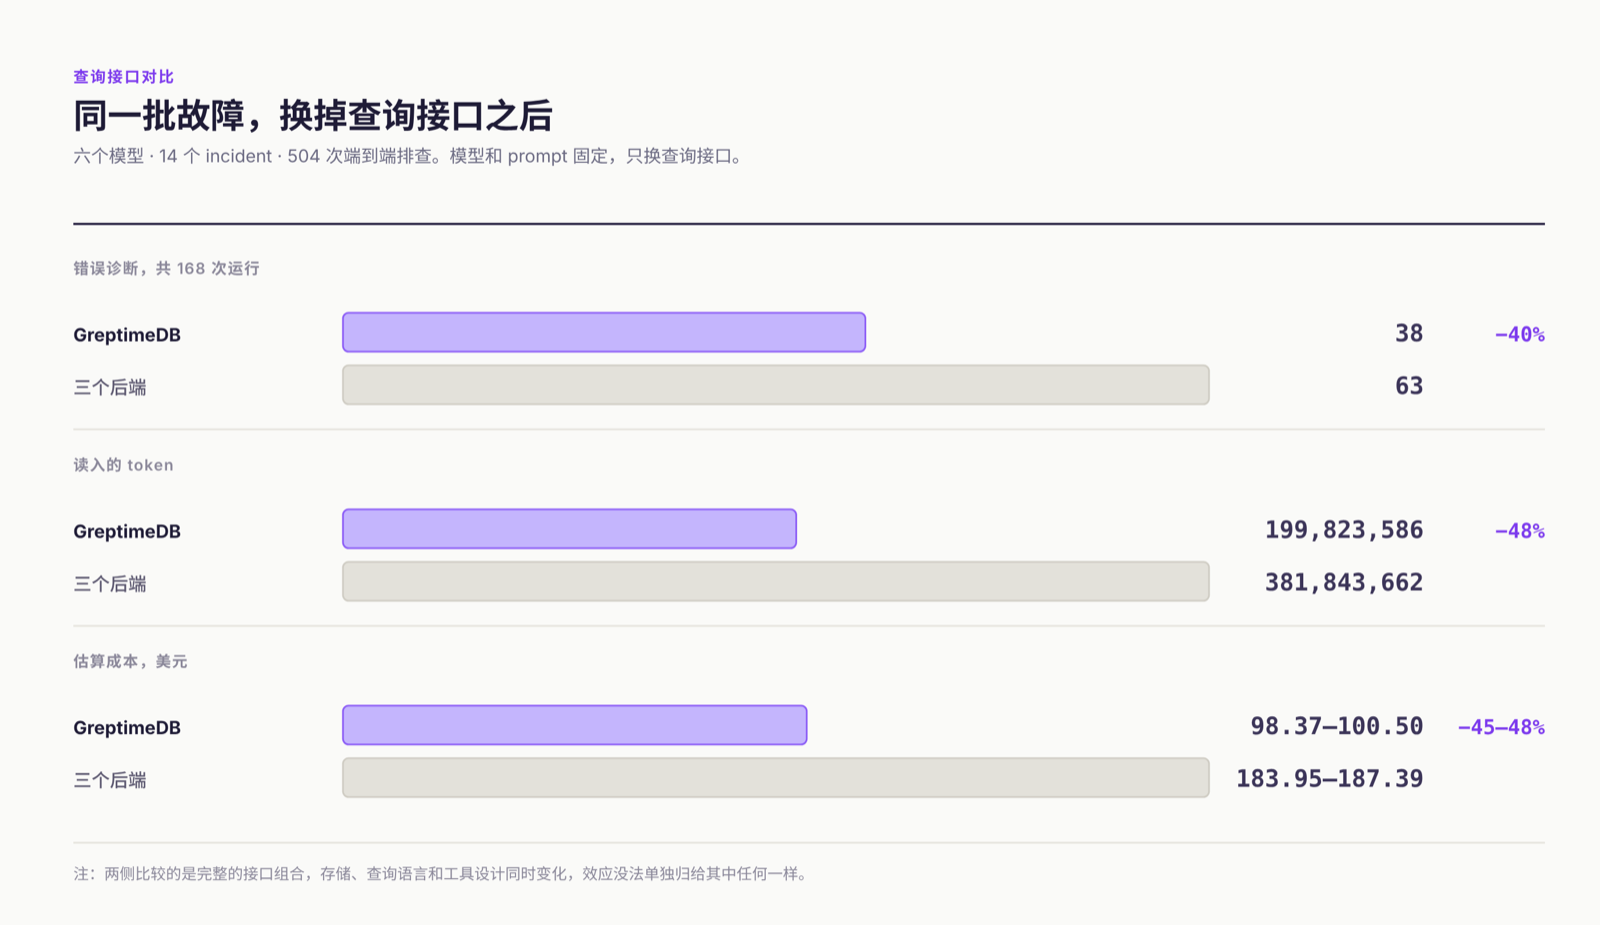
换接口的同时也换掉了存储、查询语言和工具设计三样东西,效应没法单独归给其中任何一样。
我们想把这些对齐工作移到数据库内部。
Agent 需要数据库保存语义
上面是查询量带来的代价,另一类代价来自 Agent 怎么出错。工程师不确定某个指标是不是 cumulative counter 时,往往会检查文档或者问维护者。Agent 看到的只有表名、列名和值。它拿错了语义,就可能写出语法正确、语义错误的查询,比如把 counter 直接 sum:查询成功了,图也画出来了,结果却是错误的,系统不会用报错提醒你。Grafana 2026 年的调查里,受访者把需要手工输入的上下文太多列为 AI 落地的头号障碍(26%)[5]。
这些语义只在写入那一刻是完整的。OTLP 在协议里声明了指标的类型、单位和 temporality,但写成表的行以后,单位会在行编码时被丢弃,写入后无法恢复;temporality 从指标名上也看不出来。Prometheus 这边,counter 往往只是从 _total 后缀推断出来的,并不是协议声明的。数据库如果在写入时不把这些信息记下来,上层的 MCP server、平台或者 Agent 无论怎么设计,都没有办法再补回来。所以这件事只能由数据库来做。GreptimeDB v1.3 在自动建表时把它们记成表选项:metric.type、metric.unit、metric.temporality,以及区分协议声明(declared)和后缀推断(inferred)的 metric.metadata_quality[6]。
下面是在一个 v1.3.0 实例上,分别用 OTLP 和 Prometheus remote write 写入指标后查到的结果:
sql
SELECT table_name, source, metadata_quality, semantic_options
FROM information_schema.table_semantics
WHERE table_schema = 'semantics_demo'
  AND table_name IN ('http_server_requests_total',
                     'queue_jobs_processed_total',
                     'prometheus_http_requests_total')
ORDER BY source, table_name;
+--------------------------------+---------------+------------------+-------------------------------------------------+
| table_name | source | metadata_quality | semantic_options |
+--------------------------------+---------------+------------------+-------------------------------------------------+
| http_server_requests_total | opentelemetry | declared | {"metric.original_name":"http.server.requests", |
| | | | "metric.temporality":"cumulative", |
| | | | "metric.type":"counter", |
| | | | "metric.unit":"{request}"} |
| queue_jobs_processed_total | opentelemetry | declared | {"metric.original_name":"queue.jobs.processed", |
| | | | "metric.temporality":"delta", |
| | | | "metric.type":"counter", |
| | | | "metric.unit":"{job}"} |
| prometheus_http_requests_total | prometheus | inferred | NULL |
+--------------------------------+---------------+------------------+-------------------------------------------------+前两张表来自 OTLP,类型、单位和 temporality 都由协议声明,其中 queue.jobs.processed 是一个 delta counter,原始指标名也保留着。最后一张来自 Prometheus remote write 1.0,_total 后缀暗示它是 counter,但协议没有声明,所以 metric.type 留空,只记了 inferred。
记下来之后,还要能被找到。Agent 排障的第一步,通常是找证据在哪张表、哪个信号里。语义以表选项的形式保存,就能用一条 SQL 从 information_schema.table_semantics 查出来,不必先扫一遍表名去猜。在前面那个 benchmark 里,我们把语义层单独拿出来对比:需要先定位证据所在表和信号的 35 个 table discovery 结果,返回的行数全部下降[4:1]。语义层的作用目前主要体现在找证据这一步,跨层的实体关系还在往基础设施层延伸。
找到之后,还要能用对。如果 temporality 和 metadata quality 都留在数据库里,查询层就能按语义选对算法,或者明确告诉 Agent 这只是推断。GreptimeDB v1.3 里已经有一个例子:OTLP 的 delta Sum 和 Histogram 写入时带上 otlp_aggregation_temporality="delta" 标签,PromQL 的 rate() 和 increase() 按 series 分别计算,delta 序列对区间值求和,cumulative 序列仍按 counter 计算。一条查询同时覆盖两种序列,也不会把 delta 当成 counter 去算[7]。
把这些信息丢掉,再要求每个上层工具重新猜一遍,结果只会是多套互不一致的语义层。
市场为什么绕过了这个位置
既然问题是清楚的,为什么这个位置一直空着。
今天的可观测性市场有两类主流产品。
一类是平台(Platform)。它们采集数据,提供图表、告警、服务地图、根因分析和事件响应。Gartner 对 Observability Platforms 的定义也沿着这条边界展开:存储和分析遥测数据只是必备能力之一,另外还要求跨信号探索、组件发现与映射、业务事务建模、故障原因分析、上下文富化和公有云采集[8]。
另一类是通用数据引擎。ClickHouse、Elasticsearch、Doris 都能承载相当大的可观测性负载,但它们不能把自己限定在这里。ClickHouse 还要服务实时分析,Doris 还要做数仓和搜索,Elastic 现在把公司定位放在 Search AI 上。它们把可观测性做好,是扩大市场;把自己叫作可观测性数据库,则是在主动缩小市场。
这个位置空着,未必是因为它没有价值。更直接的解释是:只有愿意放弃其他负载的数据库,才拿得起这个名字。
GreptimeDB 愿意接受这个限制。
限制也意味着责任。只把 metrics、logs 和 traces 塞进同一个列式数据库,离前面那个定义还很远。一个通用分析库同样能做到,而且可能做得很好。可观测性数据库必须回答另一个问题:当数据库知道一行数据是 counter、span、resource attribute 或者 Kubernetes entity 时,它能不能做出比通用引擎更好的决定?
标准让这个数据库第一次变得可用
这件事以前做不了,不是因为没人想到,而是专用数据库过去常死在迁移成本上。引擎可以很懂某类数据,但它要求用户接受新的 schema、SDK 和查询语言。为了换一个存储层,让所有服务重新埋点,通常不值得。
现在这道门槛低了很多。OpenTelemetry 统一了传输协议、Resource、InstrumentationScope、Attributes 和跨信号关联键;Prometheus remote write 已经是指标生态里的事实标准;Kubernetes 的资源标签也有稳定约定。数据库可以从现有数据中识别语义,不需要先说服用户采用 GreptimeDB 私有模型。
当然,我们不能只看 OpenTelemetry。2025 年 Grafana 的调查里,metrics 采用率是 95%,traces 是 57%;受访组织平均仍在使用 8 种可观测性技术。2026 年的调查里,用 OpenTelemetry 采集 metrics、traces 和 logs 的比例分别只有 57%、50% 和 48%[5:1]。Prometheus 的 job、instance 和 Kubernetes 的资源约定之所以稳定,是因为用的人太多,已经几乎改不动了。一个只理解 OTel 的数据库会漏掉大量已经存在的数据。
标准覆盖也不均匀。HTTP 和 database 的 semantic conventions 已经稳定,Kubernetes 的一批核心资源属性在 2026 年 6 月随 v1.42.0 转为 stable,部分 Kubernetes 指标仍处于 release candidate;GenAI conventions 仍处于 Development,已经拆到单独的仓库维护[9]。传统基础设施负载上的语义最可靠,Agent 相关语义反而变化最快。数据库必须记录语义的来源和可信程度:不知道时写 unknown,混合来源时写 mixed,不能为了让 schema 好看而制造一个虚假的确定值。前面提到的 metadata_quality 就是一例,unknown 和 mixed 则是 GreptimeDB 各个语义字段共用的取值[6:1]。
GreptimeDB 的语义层沿着这个方向设计,由两部分组成。第一部分是表语义,记录单张表代表什么:协议里的 signal type、source、metric type、unit、temporality 和 conventions 不应该在写成表之后丢失,它们通过表选项和 information_schema.table_semantics 继续对查询者可见[6:2]。第二部分是语义图,记录跨表的结构:行描述了哪些实体,实体之间有什么关系,通过 greptime_private.semantic_entities 和 greptime_private.semantic_relationships 两张表查询,后文拓扑一节会展开[10]。查询者今天可能是工程师,明天也可能是告警生成器、MCP server 或者排障 Agent。
物理特化由数据库完成
上一篇引过 Charity Majors 那句「支柱是个谎」。她说的是这三类数据不该被分开存放,这一点我同意。但不该分开存,不等于它们在物理上可以用同一套设计。基础设施指标通常频率高、维度相对稳定,需要以很低的单位成本保留很久。日志和 wide events 带着高基数属性,日志还要支持文本检索。Span 是宽行,既要按属性筛选,也经常按 trace_id 点查并重建调用树。没有一种 primary key、索引或 sharding 规则能同时把这些负载做到最好。
常见的反对意见正是从这里出发:metrics 是基数问题,logs 是检索问题,traces 是按 ID 查找的问题;每个数据库只能擅长其中一两样,在第三样上让步;所以不存在 observability database,只能按主导信号选库。
第一步我同意,三类负载确实是三种不同的存储问题。第二步不成立,它把「一套物理设计」等同于「一个数据库」。一套物理设计确实没法同时照顾三种负载,但一个数据库内部可以有多套物理设计,按信号分别特化,哪一类都不必让步。第三步还默认了两件事:一个团队只有一个主导信号,而且不需要跨信号回答问题。前面几节讲的,正是这两个前提不成立时要付的代价。
GreptimeDB 的差异点,不在于消灭这种特化(specialization),而在于让它由协议语义自动触发并持续优化。以 Elastic 为例。为了分别优化日志和指标,它在同一个引擎里提供了 logsdb 和 time_series 两种 index mode。两种模式的排序要求不同,用户建索引时要选择,也要理解选择的后果[11]。特化在这里通过配置暴露给了使用者,而这个选择引擎本来可以自己做:这批数据是日志还是指标,数据里就带着。
规则只有一条:协议确定的部分,引擎自己定;协议不确定的部分,不硬猜,而是选择更通用的方式处理,再根据真实负载调整。下面几个例子都是这条规则。
OTLP trace 自动建表时,表结构就是 span 的结构。duration_nano 完全可以从 timestamp 和 timestamp_end 算出来,还是物化成了一列,因为引擎知道 duration 是用来过滤和排序的那个值。物理设计同样来自协议:纳秒精度的时间索引,service 和 operation 附加表一并生成[12]。这些你一样都不用配。
这套设计还可以持续演进。从 v1.3 起 trace 有了第二个数据模型:v1 把 attributes 平铺成独立的表列,v2 把它们收进三个固定的 JSON2 列。换的原因来自真实的用户场景:同一个 attribute key,不同 SDK 和不同编程语言给出的类型并不一致——第一次写入是 string,后面来的可能是空字符串,也可能是 int。平铺成列时,v1 只能尽量转换,转换不了的 span 会被拒绝;JSON2 没有这个问题。这类事情协议不会告诉你:OTLP 不声明 attribute 的类型契约,答案取决于你那一批 producer 的行为。所以引擎不硬猜,v1 和 v2 通过 pipeline header 选择。
compaction 的参数也落在这条规则上。通用数据库里,TWCS 的时间窗口、触发文件数和输出文件大小通常要靠人或者外部工具调;窗口选错,查询会变慢,写入会放大,事后改窗口还会触发一次历史数据重写。GreptimeDB 里,这些参数有一部分直接由语义决定:Metric Engine 的物理表默认用一天的 compaction 窗口,对长时间范围的指标查询更友好。
扩展(scale)也是同一条规则。分布式数据库扩展时要回答两个问题:数据沿哪个键拆开;什么时候拆,拆成几份。前一个问题可以由语义回答,后一个问题只能由负载回答。trace 的语义回答了第一个:按 trace_id 点查是最常见的访问方式,trace ID 又通常随机生成,所以 trace 表默认按 trace_id 首字符分区,写入分散到各个 region,同一条 trace 的 span 落在同一个分区里[12:1]。metrics 没有这样通用的分区键,数据库不会为了看起来自动就硬选一个。Metric Engine 让大量逻辑指标表共享物理表,扩展的对象是物理表的 region,与指标名的数量无关[13]。Region Balancer 会按写入和查询负载把 region 迁到负载更低的 datanode。这些动作都以共享对象存储为前提,节点之间转移的是 region 的归属,不是数据文件本身[14]。
特化也不止于建表时的选择,我们也在为 PromQL 开发专门的存储布局和执行路径。同一条规则在 metrics 和 traces 上落成的物理设计是这样的:
| metrics | traces | |
|---|---|---|
| 引擎与表模式 | Metric Engine,大量逻辑指标表共享一张物理宽表,稀疏 primary key 编码 | Mito Engine,由协议建成 append-only 表,primary key 为 service_name |
| 分区 | 没有通用分区键,初始不硬选;什么时候拆、拆成几份交给负载(企业版 Auto Repartition) | 按 trace_id 首字符拆成 16 个分区 |
| 索引 | 倒排索引分段调小到 256 行,适配指标的小索引 | trace_id、service_name、parent_span_id 三列上的 skipping index |
| compaction | 物理表默认一天窗口 | 不需要去重;暂无专门窗口,按已有文件的时间跨度推断 |
统一的是逻辑模型、存储和查询引擎,不是要求所有信号共用同一套物理设计。
拓扑本来就在遥测数据里
一条 span 已经写出了调用方、被调用方和发生时间。Resource attributes 记录了指标或日志属于哪个 service、pod 和 node。这些数据本身就是实体与关系的证据。
常见做法是在旁边再维护一份 service catalog 或者 graph store。代价是同步。服务改名、部署迁移或者标签变化之后,catalog 和遥测数据可能悄悄对不上。系统默认不会报错,直到一次故障排查同时得到两个互相矛盾的答案。
GreptimeDB 选择从遥测数据派生实体和关系,把图保留为逻辑视图,也就是前面说的语义图。v1.3 已经提供,目前仍标为实验功能:greptime_private.semantic_entities 和 greptime_private.semantic_relationships 两张表在查询时由已存储的遥测数据计算,不另外落盘;由 trace 生成的 calls 边带 RED 指标;多跳遍历用 WITH RECURSIVE 写成普通 SQL,SQL/PGQ 的图查询语法还没有实现[10:1]。
派生视图也会滞后,但滞后可以衡量并且设上界;独立 catalog 的偏差没有天然上界。需要更低查询延迟时,可以用 Flow Engine 在写入时增量维护物化视图,逻辑定义仍然只有一份。
这里还有一个容易被忽略的点:关系天然带时间。A calls B 只在某个窗口内成立。发布结束、实例退出或者路由切换之后,关系会变化。一个脱离时间的 service catalog 在持续陈述一个部分过期的世界,这对于故障排查反而是一个拖累。GreptimeDB 的派生边按 60 秒窗口记录,「当前拓扑」就是对最近几个窗口的查询,不再产生遥测的实体和边自然消失[10:2]。
这一层不只供 Agent 使用。我们在 GreptimeDB Dashboard 里基于它做了 service map,一张实时的服务依赖图。节点、调用边,以及边上的请求数、错误数和耗时,都来自对这两张表的几条带时间范围的 SQL;Dashboard 不自己配对 span,也不维护单独的拓扑存储。它只是这层数据的一个消费者,同样的查询也可以由 Grafana、MCP server 或者排障 Agent 发出,所以不越过前面说的产品边界。
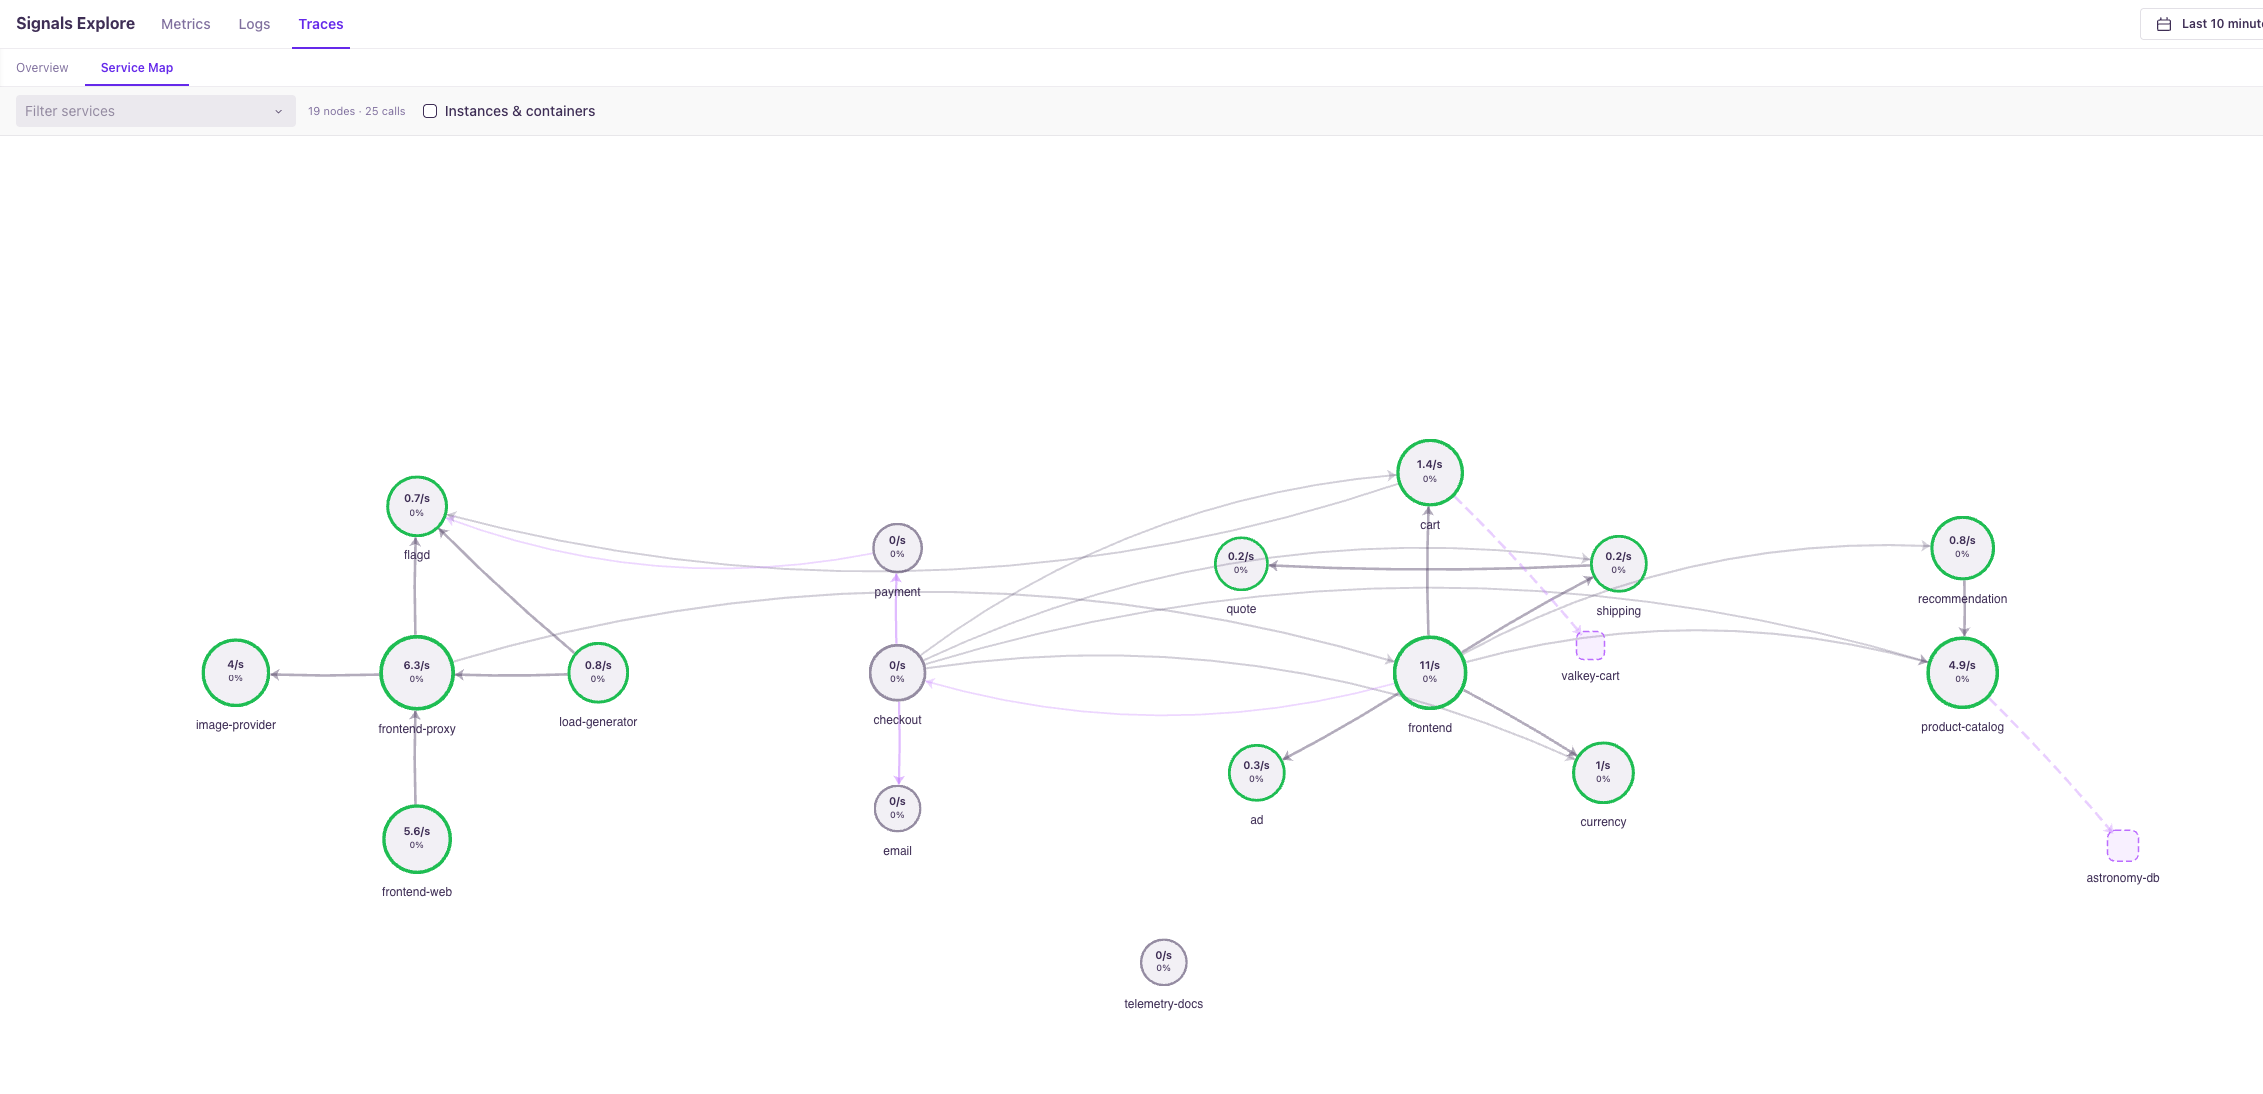
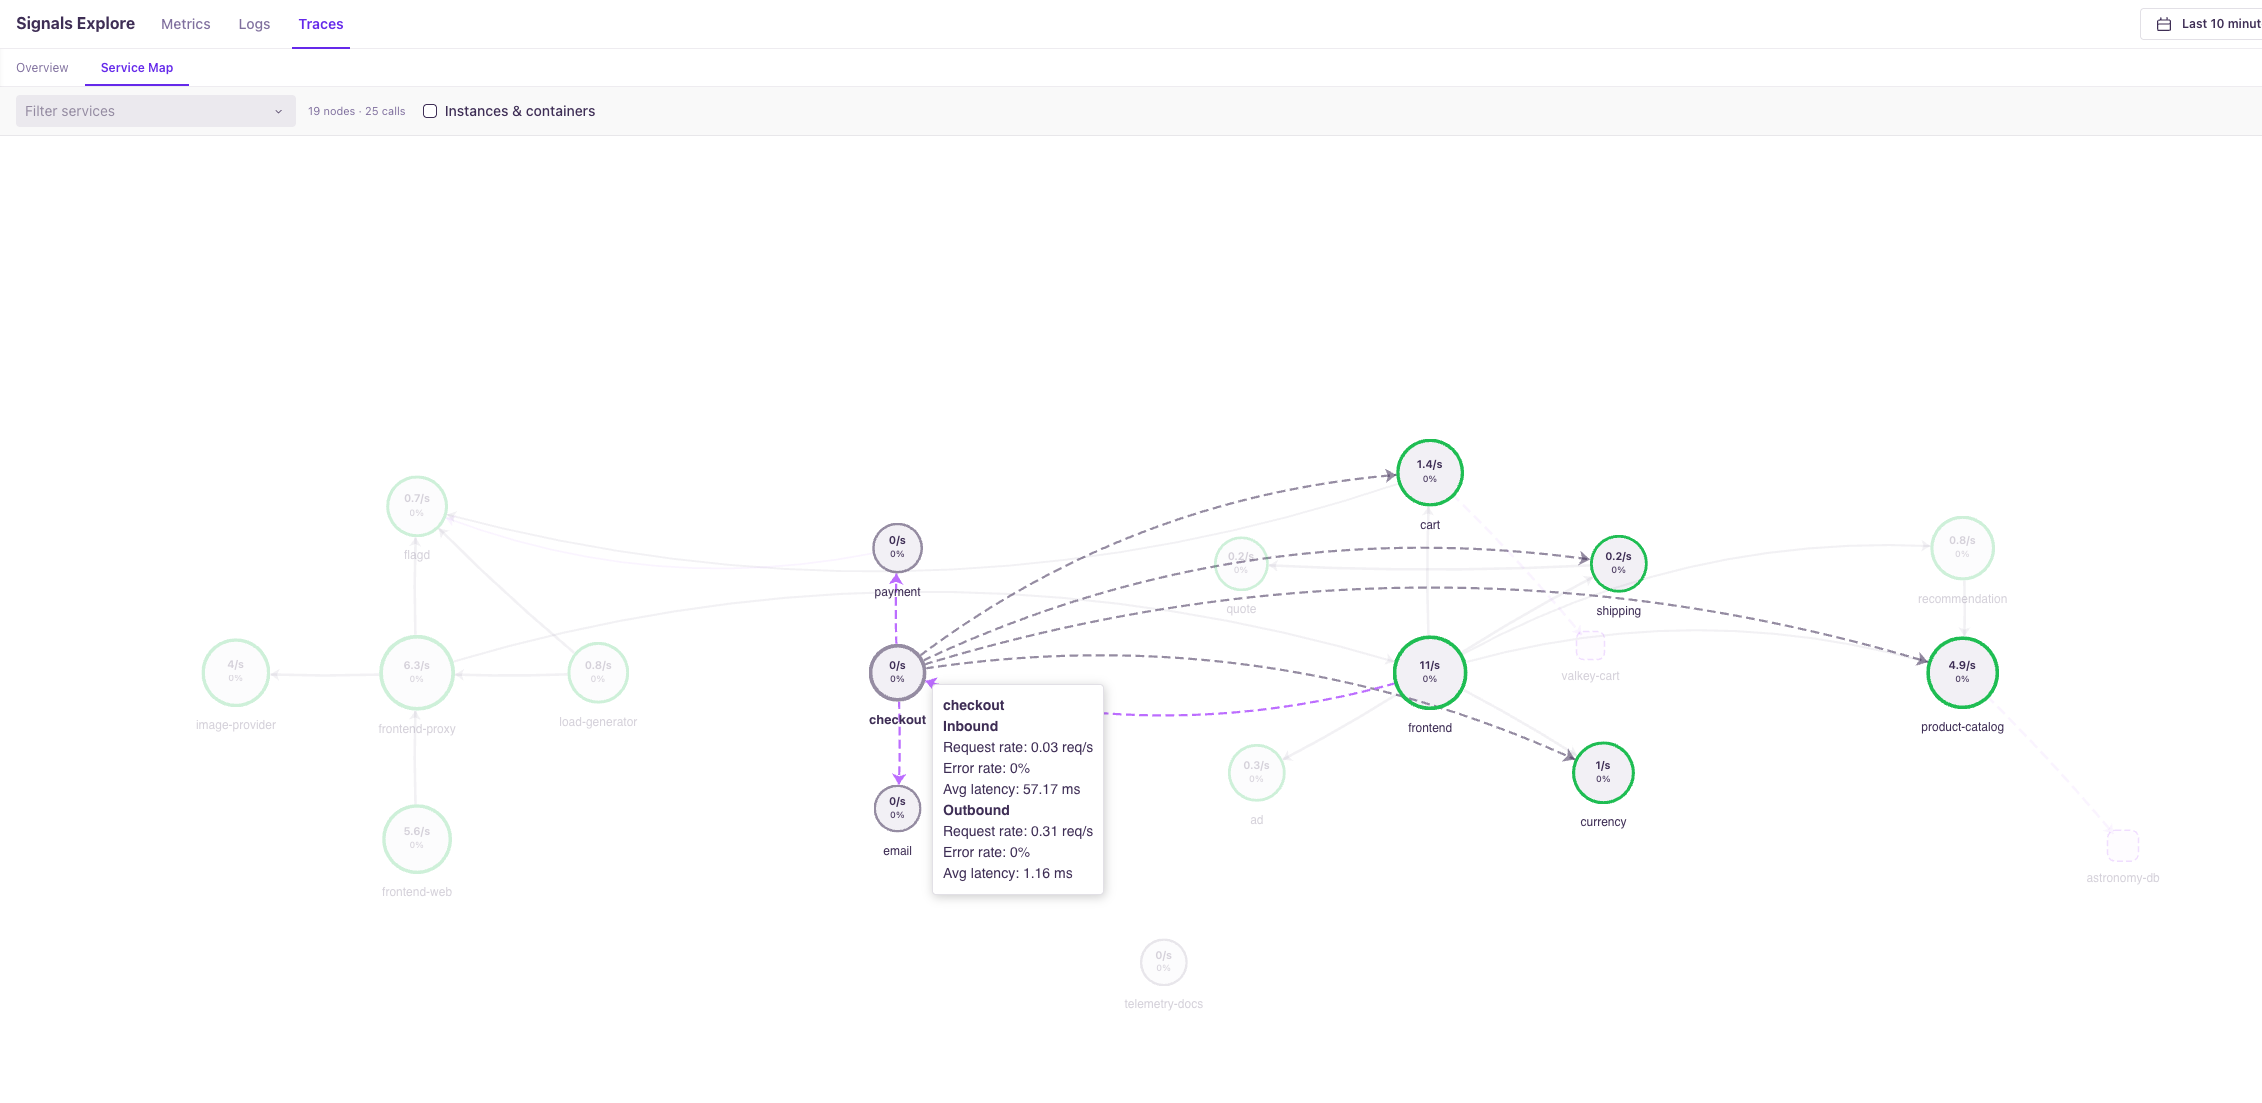
service map 已合并进 Dashboard 主干,尚未包含在 v1.3.0 内置的 Dashboard 中[15],预计随 v1.3.1 发布。
这一层的效果也放进了同一个 benchmark。图能直接回答依赖问题:依赖检索的 12 个结果里,11 个同时减少了返回行数和调用次数[4:2]。效果集中在图上有边的地方。基础设施节点故障这类用例里,问题出在 node 上,而图目前走到 service 和 pod;下一步是把 service 到 pod 再到 node 这条链接完整。v1.3 已经零配置接上了一段:kube-state-metrics 给出 pod 运行在哪个 node 上,带 k8s.pod.uid 的 trace 能关联到对应的 pod,只要各张表对同一个实体使用同一个标识值[10:3]。
统一的代价
统一不要求在某一类信号上让步,但它有代价。按信号特化,意味着要在一个数据库里维护多套物理设计和执行路径,工程投入远大于只做一种信号;额外的布局和索引也要占用存储和后台维护。我们的另一个选择是把扩展性放在单机性能前面:依靠分布式执行和存算分离扩大容量与吞吐,同时获得跨信号的实时语义查询。存算分离还带来一个好处:compaction 以及随之重建的索引这类后台任务,不必和写入、查询抢同一批节点,可以交给独立的、可扩展的节点执行,也就是 remote compaction(GreptimeDB 企业版提供)。
对象存储也带来明确的代价。Parquet 擅长大范围顺序扫描,不擅长按 trace_id 取一条记录。一次点查可能触发多轮串行 HTTP range request[16]。GreptimeDB 用本地缓存和冷热分层缓解,冷数据点查仍然比热数据慢。这个代价来自对象存储,不是来自统一:Tempo 同样把 trace 以 Parquet 存在对象存储上。
产品边界仍然要守住。Observability Database 位于 Observability Platform 下面,不试图吃掉上面所有层。
关键告警我们仍然建议放在本地 Prometheus 上。Prometheus 强调每个 server 都应 standalone,不依赖网络存储或者其他远程服务,这个原则没有过时[17]。本地 Prometheus 评估需要通知值班人员的告警规则,数据同时远程写入 GreptimeDB,用于长期留存、跨信号关联、dashboard,以及实时和历史查询。GreptimeDB 也有自己的告警能力:Trigger 用 SQL 定义规则,按固定间隔求值,以 Alertmanager 兼容的格式推出去[18],适合跨信号、长时间窗口这类本地 Prometheus 评估不了的规则。
可视化继续交给 Grafana,以及 CNCF 的 Perses[19]。数据采集继续兼容 OpenTelemetry Collector 和 Prometheus 生态。我们没有理由再发明一套 dashboard、一套 agent 或者一门查询语言。
这些边界和代价都属于定义本身。可观测性数据库不能只讲统一带来的便利,也要说明它为了统一放弃了什么。
这个名字要如何被证明
「Observability Database」短期内不会带来现成的搜索流量,也不会让 GreptimeDB 出现在 Observability Platforms 的 Magic Quadrant 里。它首先是一项产品承诺:
- 遥测语义进入数据库后不能丢;
- metrics、logs、traces、wide events 和未来的 signals 在逻辑上可以关联,并支持实时语义查询;
- 数据库应根据协议语义生成初始物理设计和分片方式,再根据真实负载持续优化索引、primary key、append-only、sharding 和扩展;
- SQL 和 PromQL 由同一个查询引擎执行;
- 数据库不越过告警、可视化和事件响应的产品边界。
这个名字最终要由用的人来认。如果平台工程团队和做可观测性产品的人开始用「observability database」称呼这一层,并拿上面几条来衡量它,这个品类才算成立。
GreptimeDB 先把这个名字写在了首页。接下来要靠产品把它变成一个有用的定义。
如果你想直接验证,可以把现有的 OpenTelemetry Collector 或者 Prometheus remote write 指向 GreptimeDB,再用 SQL 查询跨信号数据、用 SQL 和 PromQL 分别查询指标。文档在 docs.greptime.cn;实体关系的完成项、未完成项和已知难点在 issue #8609;上面那些数字的完整方法、原始记录和限制说明在 Agent RCA Bench。
参考资料
换掉查询接口,Agent 根因分析的错误诊断少了 40%;Agent RCA Bench 榜单与原始记录 ↩︎ ↩︎ ↩︎
Grafana Observability Survey 2025;Grafana Observability Survey 2026;Grafana Labs 2026 调查发布稿 ↩︎ ↩︎
GreptimeDB 文档:表语义;GreptimeDB RFC:Table semantic layer ↩︎ ↩︎ ↩︎
OpenTelemetry semantic conventions v1.42.0 release notes;open-telemetry/semantic-conventions-genai;2026 semantic conventions roadmap;OpenTelemetry:Kubernetes attributes processor reaches v1.0.0 ↩︎
GreptimeDB 文档:语义图;GreptimeDB 文档:声明实体和关系;GreptimeDB issue #8609:Entity relationships and graph query ↩︎ ↩︎ ↩︎ ↩︎
GreptimeDB 文档:数据建模指南与 Metric Engine;GreptimeDB RFC:Repartition ↩︎
GreptimeDB 企业版文档:Auto Repartition;GreptimeDB 企业版文档:Region Balancer;GreptimeDB 文档:Region 迁移;GreptimeDB 文档:Repartition ↩︎
ClickHouse:Are open table formats and lakehouses the future of observability? ↩︎


