本页内容
概览
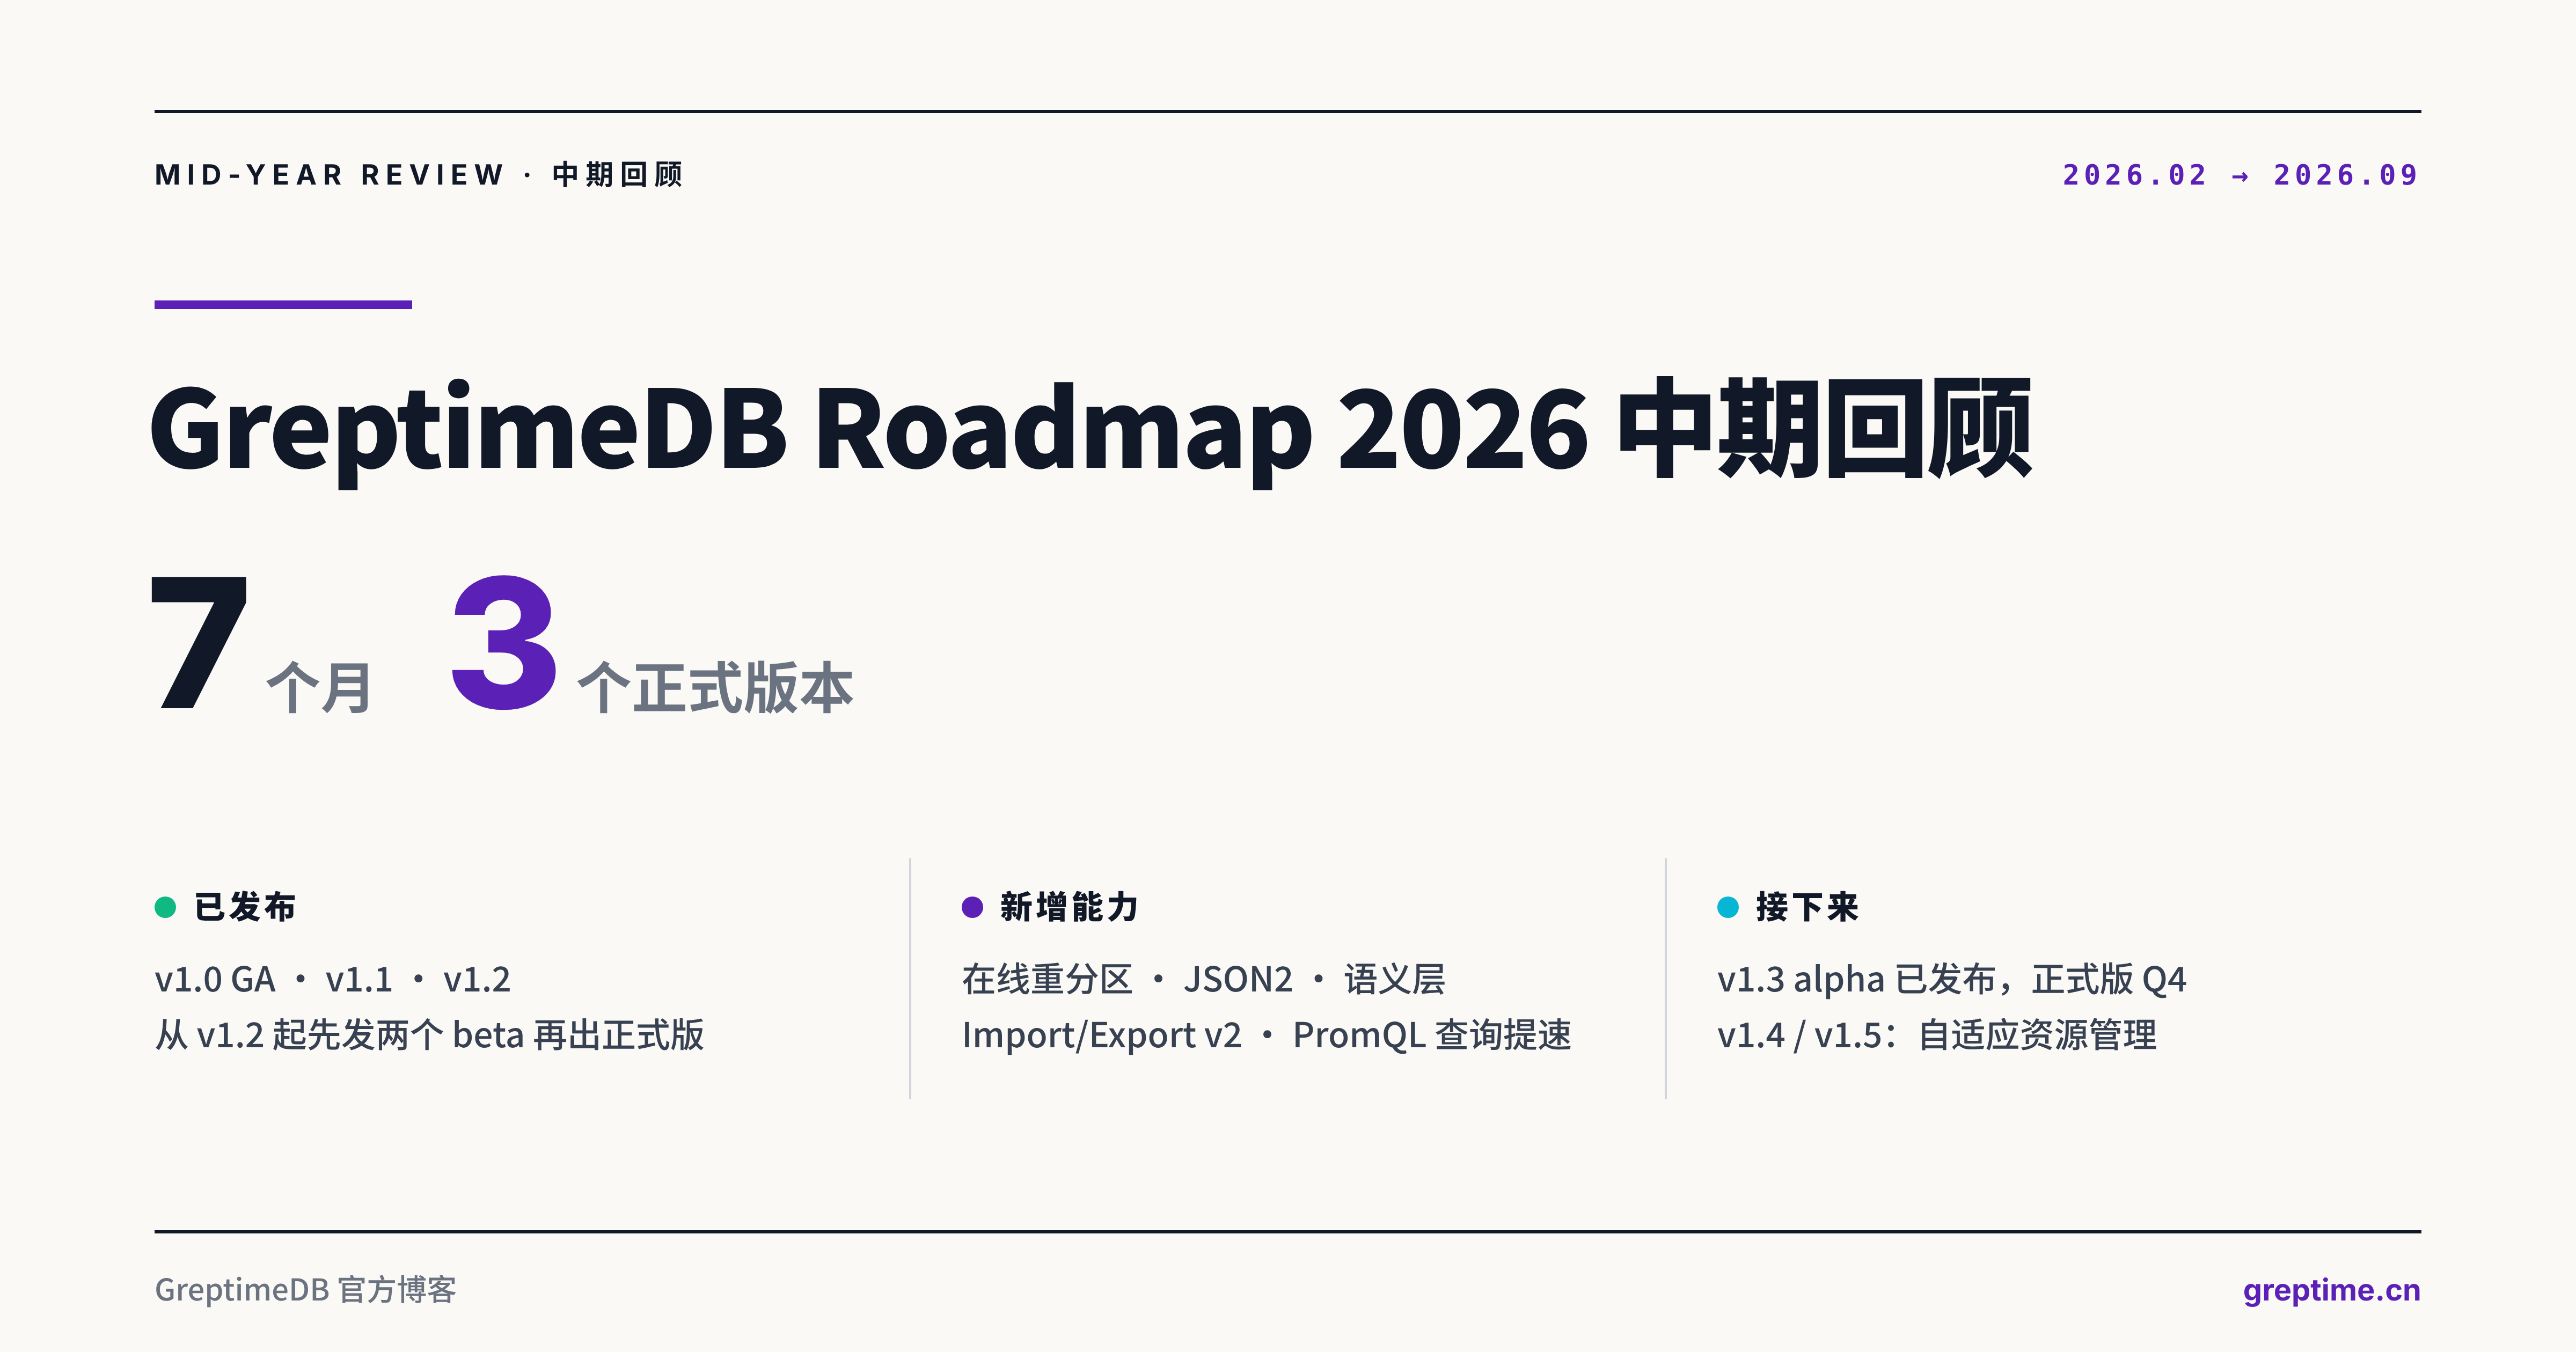
2 月我们发布了 GreptimeDB Roadmap 2026。7 个多月过去,这是截至 9 月中的进展。
这期间我们发布了 v1.0 GA、v1.1 和 v1.2,补上在线重分区、JSON2 类型、导入导出 2.0 和实验性的表语义层,也做了不少查询和写入优化。自适应资源管理、Remote Compaction/Indexing 从原型转入生产实现这两项原定工作,推迟到 v1.4 和 v1.5。
里程碑
| 版本 | 2 月计划 | 当前进展与调整后计划 |
|---|---|---|
| v1.0 GA | 3 月底 | 4 月 8 日发布 |
| v1.1 | Q2:Remote Compaction/Indexing 转生产、Metric Engine 优化、Vector Index 与 AI Functions、Import/Export v2、JSON2 类型 | 6 月 14 日发布,6 月 18 日 v1.1.1。实际内容:在线重分区、表语义层、查询性能提升 |
| v1.2 | Q3:自适应资源管理一期、Auto Rollup、Flow 引擎增强、Major Compaction | 8 月 1 日发布 beta.1,8 月 21 日发布 beta.2,9 月 8 日发布正式版,9 月 16 日 v1.2.1。重点改为 JSON2 类型、Import/Export v2 |
| v1.3 | Q4:自适应资源管理二期、Pandas DataFrame SQL、Log Context Search、开放表格式兼容 | 9 月 3 日发布 alpha.1,正式版目标 9 月。重点改为 Metric Engine 优化、Compaction 优化 |
| v1.4 | — | 计划于 Q4 发布:自适应资源管理一期、Auto Rollup、Flow 引擎增强、Major Compaction |
| v1.5 | — | 计划于 Q4 末发布:自适应资源管理二期、Remote Compaction/Indexing 转生产、Log Context Search、开放表格式兼容 |
计划为什么调整
写 roadmap 的时候,我们打算每一两个月迭代一个版本,上半年也确实这么做了。但每次发版之后,紧跟着就得发一两个 fix 版本。月度发版加上 flat 格式、JSON2 类型、原生直方图这些大改动,部分兼容性问题等用户碰到才暴露。所以从 v1.2 开始改成先发两个 beta,两个 beta 没有严重问题再出正式版。
和用户、社区的交流,加上 PoC 里提出的需求,让我们重排了优先级:查询与写入优化、安全增强、语义层加了进来;Vector Index、AI Functions 和 Pandas DataFrame SQL 取消,精力更多放在遥测数据的查询与存储上。
计划外的主要交付
这七个月投入最多的几项工作,2 月的 roadmap 上都没有。
语义层(进行中、实验性质):把 OTLP 中的类型、单位、temporality 等语义信息随数据一起保留下来,v1.1 引入,v1.3 补上 Prometheus Remote Write v2 的指标类型和单位。在此之上,v1.3 会提供实验版的实体关系图,直接从遥测数据里查出服务之间的调用关系,以及调用量、出错情况和耗时,不用另外维护一份服务目录(#8609)。MCP Server 已经用这些信息给 AI 助手提供上下文。
查询性能:v1.1 的基准测试中,PromQL 平均查询耗时下降 20% 到 40%,TSBS 的
cpu-max-all-8查询快了 4.5 倍。这一轮改进包括rate、increase等 range 函数优化,以及通过 page index 减少 SST 数据读取。后续版本继续优化过滤下推(v1.1.3)和序列键的字典编码(v1.2)。这些是基准测试的结果,实际提升取决于数据和负载。写入性能:v1.0 为 Prometheus Remote Write 加入批处理;v1.2 让每个 region 有独立的写入缓冲区限额,单个 region 的写入压力不再影响其他 region。v1.3 在做的跨协议批量写入会把这套批处理扩展到各类 HTTP 写入接口。
查询引擎:DataFusion 从 v1.0 的 52 跟进到 v1.3 的 55,带上了上游的规划与执行优化。
存储格式:flat SST 成为默认格式(v1.0,可回退);稀疏主键编码成为默认行为(v1.2)。
Dashboard:v1.1 的 Perses 面板可以查看 trace 列表和单条 trace 的甘特图;v1.2 加入查询快照、命令面板和全屏结果。
生态与协议:Splunk HEC 摄入、gRPC-Web、MySQL 作为 object store 后端,以及
COPY FROM支持跳过坏行和无表头 CSV。
分项进展
以下按 2 月 roadmap 的分类逐项说明进展。
高可用与可靠性
Remote Compaction/Indexing 转生产:移至 v1.5。
热更新配置:未开始。
计划外:对象存储 WAL(进行中、实验性质)。WAL 直接写入对象存储,集群不再依赖 Kafka,尚未进入发布版本。
数据库可运维性
Import/Export Tool v2:已交付。v1.0 起步,v1.2 加入并行分块与断点续传。
Major Compaction:移至 v1.4。
计划外也补了几项运维能力。在线重分区在 v1.1 补齐,无分区表也可以直接拆分。v1.2 加入
ADMIN discard_unflushed,坏数据卡住 flush 时,可以只丢弃内存中的数据,保留落盘数据;事件记录和SHOW FLOW STATUS则方便排查 DDL、集群和 Flow 的运行问题。流式EXPLAIN ANALYZE在 v1.3 从实验特性改为正式特性。安全:用户密码哈希存储(v1.1);SQL 本地文件访问沙箱、表级权限、Postgres SCRAM 认证、独立 API 端口(v1.2);HTTP Bearer Token 认证(v1.3)。本地文件访问沙箱是破坏性变更,老版本的本地导入导出路径需要按 release note 调整。
自适应资源管理
两期交付的版本从 v1.2 / v1.3 改为 v1.4 / v1.5,原因是优先级调整:查询与写入优化、安全和语义层排在了前面。写入、查询、compaction 现有的分项限额在目前的负载下够用,统一的自适应管理不是最急迫的需求。内存限额和调度做了一部分,还没统一起来,有些仍是默认关闭的实验特性。
细粒度内存跟踪与控制:进行中。写入、查询和 compaction 已有各自的内存限制,每个 region 的写入缓冲区也有独立限额;统一的内存管理还没完成(#7094)。
基于成本的自适应调度:进行中。scan 已按输出字节计量开销;查询与写入之间的加权调度仍是默认关闭的实验特性,compaction 和 flush 还没接入(#8736)。
零调参自适应 spill:进行中。目前先提供了实验性的 spill 配置,可以设置临时文件路径、空间上限和压缩,也可以禁用(#8884)。
感知负载的 compaction 调度:进行中。已限制任务挑选线程数和阻塞线程池规模,任务挑选策略按 #8575 调整。
自适应缓存管理、资源配额与准入控制:未开始。
Metric Engine 优化
写入优化:Bulk ingestion for OSS:已交付(v1.0)。
Compaction 优化:做了一部分,剩下的进 v1.3。
Prometheus Remote Write 2.0:v1.2 支持新协议,以及原生直方图的摄入、校验和存储,摄入默认关闭。v1.3 alpha 补上查询,可以汇总这些数据并通过 Prometheus 查询接口读取;传统和原生直方图也能在同一次查询中分别计算分位数,例如 95% 的请求在多久内完成(P95)。此外还能接收 OpenTelemetry 持续累计的分布统计(累计型指数直方图)。
元数据管理优化(高基数场景)、自动多值优化:未开始。
计划外:Series index(进行中)。查询先按 tag 找到匹配的时间序列,再通过 SST 上的 range index 定位对应的数据,减少无关数据的扫描;两阶段 series 扫描还支持将这些序列分配到多个输出分区,并行读取。
Flow 引擎
扩展时间窗与聚合函数:进行中,增量聚合的 delta merge 已合入代码,其余放在 v1.4。
计划外:v1.1 加入实验性的增量读。此前每次计算都要重新扫描全部源数据,现在只读上次执行后新增的部分。
日志与链路
JSON2:v1.2 交付新的 JSON 类型,新的存储布局随正式版启用。它会在设定上限内展开 JSON 路径,超出上限的部分仍会保留,查询时可以还原完整 JSON;字段级索引还未开始。旧 JSON 类型的表升级到 v1.2 有已知的兼容问题,迁移方式见 release note;v1.2.1 还修了一个 compaction 期间的 JSON2 数据丢失问题,建议直接用 v1.2.1。
Log Context Search:移至 v1.5。
计划外:链路方面,v1.1 支持自定义 trace 表的分区规则和 trace 类型白名单;v1.3 在做 trace v2 摄入,attributes 改用 JSON2 存储。
新特性
Vector Index 与 AI Functions:取消,v1.4 计划移除现有 Vector Index 实现。
Auto Rollup:移至 v1.4。
Pandas DataFrame SQL:取消。后续会做 CBO(基于代价的优化器)等查询优化。
开放表格式兼容(Iceberg/DeltaLake):Iceberg 已在企业版实现, DeltaLake 实现推迟。
接下来怎么安排
v1.2 发布之后,重心在 v1.3,交付更多 PromQL 优化和 Compaction 优化。自适应资源管理继续做,分两期在 v1.4、v1.5 交付。
v1.4 和 v1.5 都排在 Q4,实际可能把其中一部分功能合并到同一个版本发布。
版本时间为预估,会按实际进度调整。
相关讨论见 roadmap issue #7685。
参与
有 tracking issue 的条目可以直接在 issue 里讨论。其他想法欢迎在 roadmap issue 留言、发起 GitHub Discussion,或者来 GreptimeDB Slack。


