本页内容

日志、trace 和事件流里的 JSON 有一个共同点:每条记录结构相似但不完全相同,一次分析通常只用到其中几条 path。比如统计 5xx 请求数,只需要 http.status 这一个值。
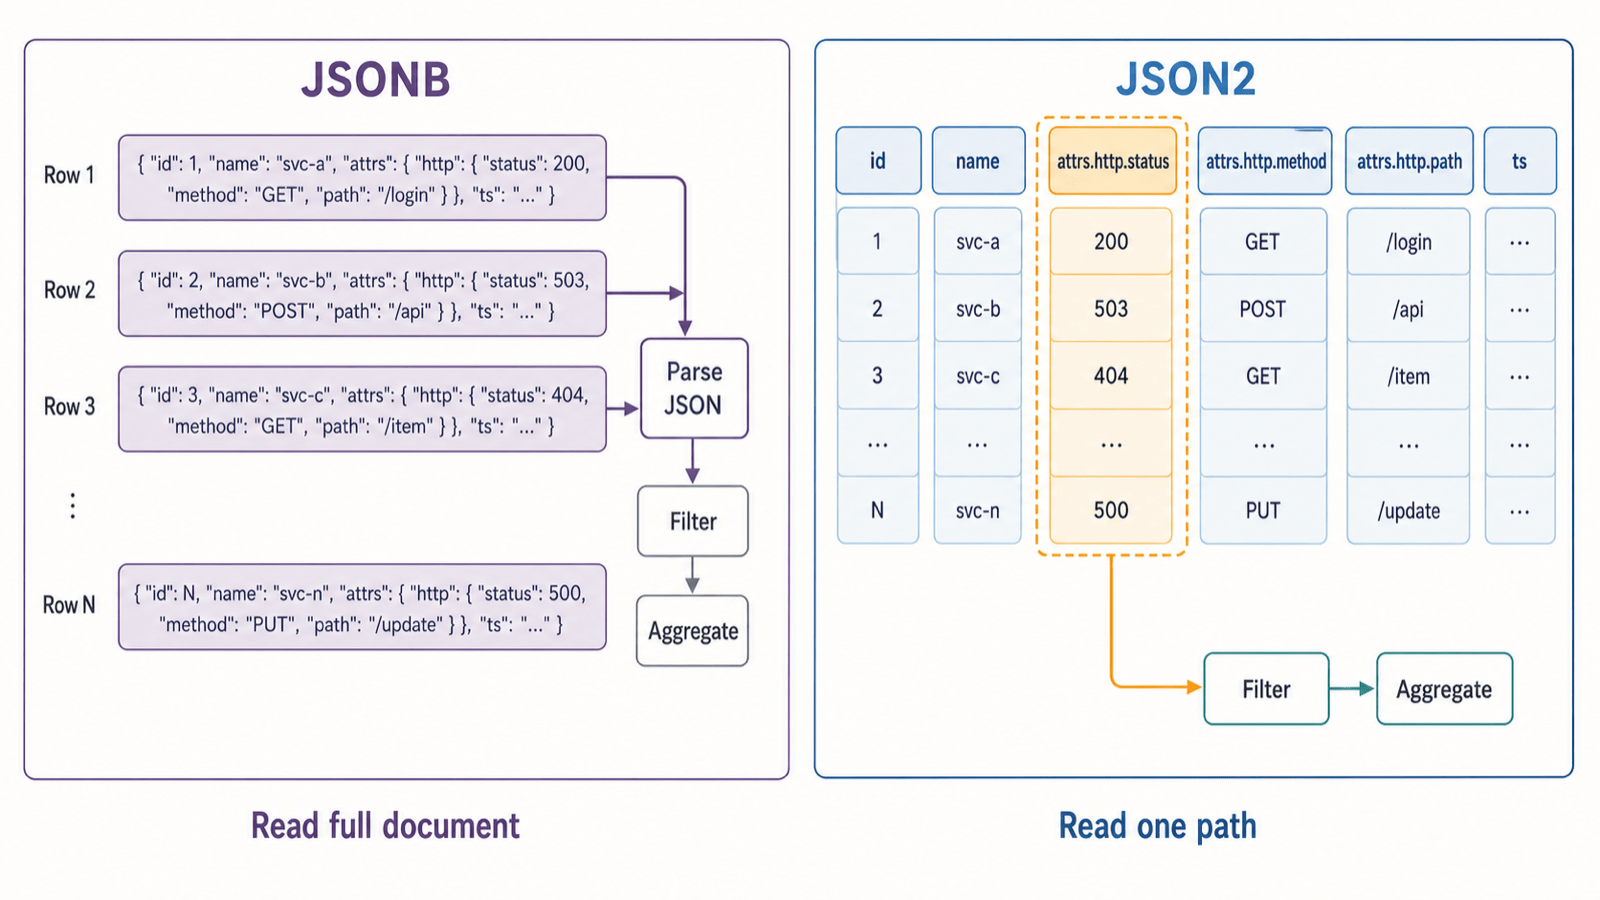
GreptimeDB 原有的 JSON 类型把整个 JSON 编码为 JSONB,作为一个二进制值保存。为了读 http.status,存储引擎要读出每行完整的 JSONB,查询引擎再逐行解析定位。查询只用到一个字段,读取和解析的却是整个文档,存储带宽和 CPU 大部分花在了用不到的字段上。对于低频读取完整对象、或者 schema 完全无法预知的数据,JSONB 依然简单可靠;放到日志或链路分析这类查询上,它的开销就很明显了。
GreptimeDB 1.2 新增的 JSON2 为这类数据设计:用户看到的仍是一个完整的 JSON 对象,存储和查询引擎看到的则是可以按 path 裁剪的结构化数据,常用 path 各自成列,查询可以只读取它用到的列。本文从 JSONB 的限制讲起,介绍 JSON2 的分层存储、查询时的类型推导和 type hint。文中示例基于当前最新稳定版本 v1.2.1。
从整文档 JSONB 到结构化 JSON
JSONB 的物理边界是整个 JSON 文档。以统计 5xx 请求为例:
sql
SELECT COUNT(*)
FROM application_logs
WHERE json_get_int(attrs, 'http.status') >= 500;
attrs 在存储引擎里是一个二进制列。查询只需要 http.status,存储引擎却只能按行读出完整的 attrs,再从中定位 http.status,无法只提供查询需要的那部分数据。
给 JSONB 加索引是常见的思路。PostgreSQL 在 JSONBench 上的结果可以说明这条路的效果。
当 PostgreSQL JSONB 遇到 JSONBench
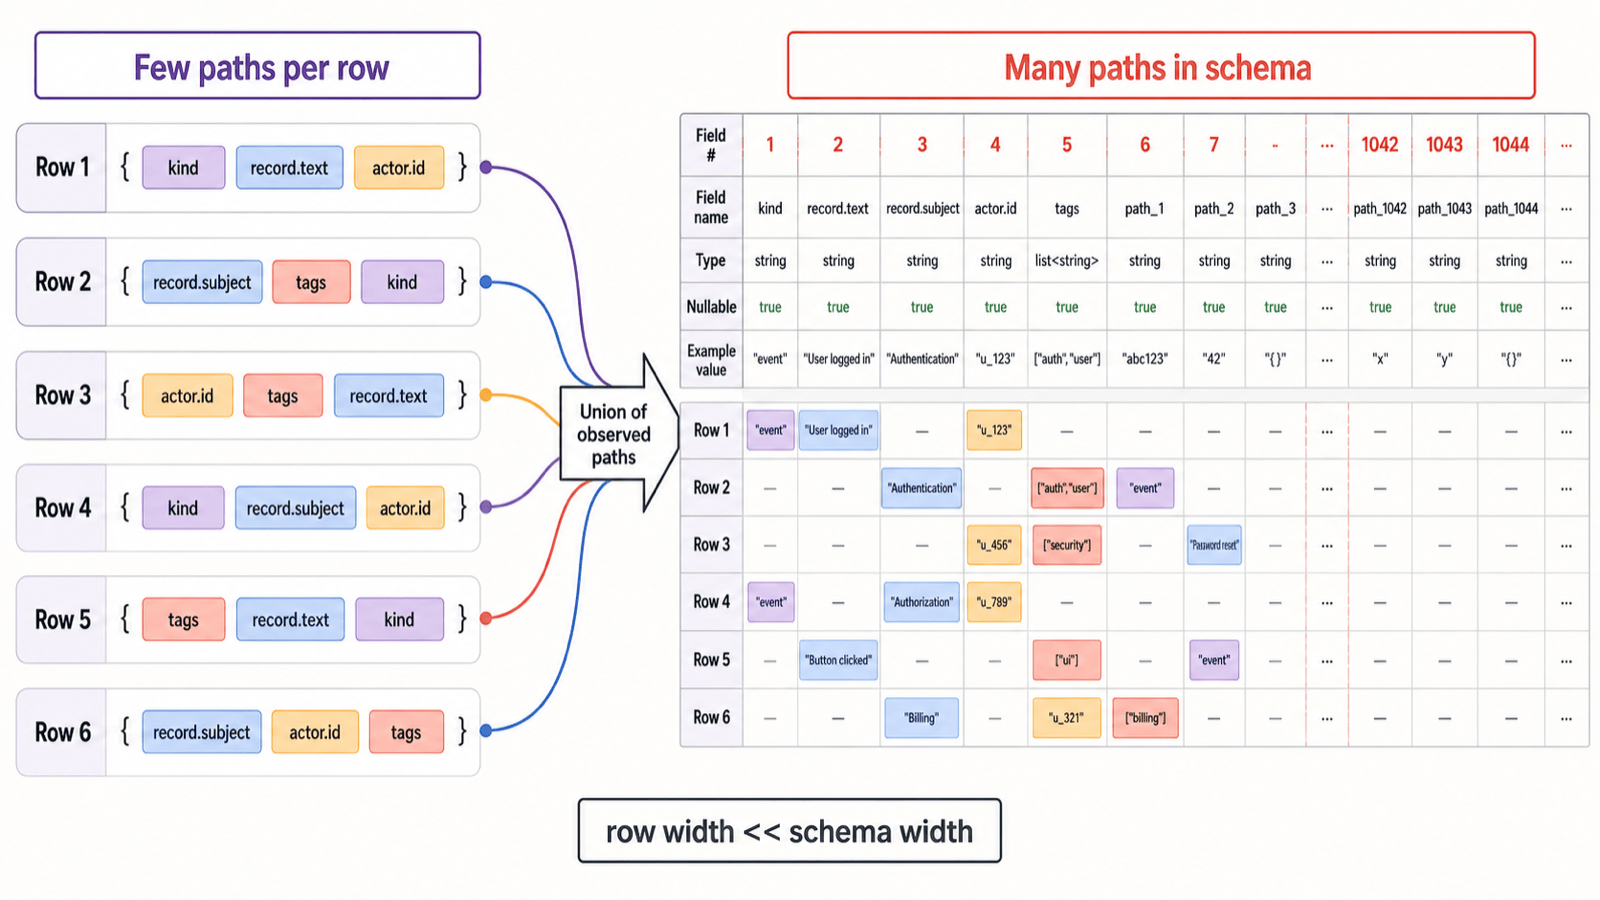
JSONBench 使用从社交平台 Bluesky 抓取的十亿级真实 JSON 数据做性能测试。这份数据的特点是字段多、嵌套深、不同行的 schema 差异明显;整个数据集的 JSON path 集合很大,单行 JSON 只包含其中很少一部分。它是典型的宽而稀疏的半结构化数据。
PostgreSQL 16.6 在十亿行这一档的公开结果中,实际写入约 8.04 亿条数据,数据落盘约 512 GB,索引约 148 GB,总计约 660 GB;五条查询在三次运行中的最好成绩都在 1.1 到 1.4 小时之间:PostgreSQL JSONBench result。
这个结果反映的是场景不匹配,与 PostgreSQL 的 JSONB 和 GIN 索引的实现质量关系不大。索引解决的是"哪些行可能满足条件",没有改变 JSONB 的物理边界。找到候选行后,PostgreSQL 仍然要读取对应的 JSONB value,再从中提取目标字段。JSONBench 这类查询需要扫描或聚合大量匹配行,查询引擎无法像列式数据库那样只读取某条 JSON path 的值,也无法让这条 path 单独参与压缩和向量化计算。
GreptimeDB 此前在 JSONBench 上的实现走了另一个方向:把 JSON 中的常用 path 直接抽取成表列。分析性能很好,但带来了额外的存储,用法也不直观。
JSON2 要同时避开这两种做法的问题:数据不再作为一个 JSONB 二进制值保存,用户也不需要预先把常用字段抽成表列。
JSON2:在静态列式格式上承载动态 schema
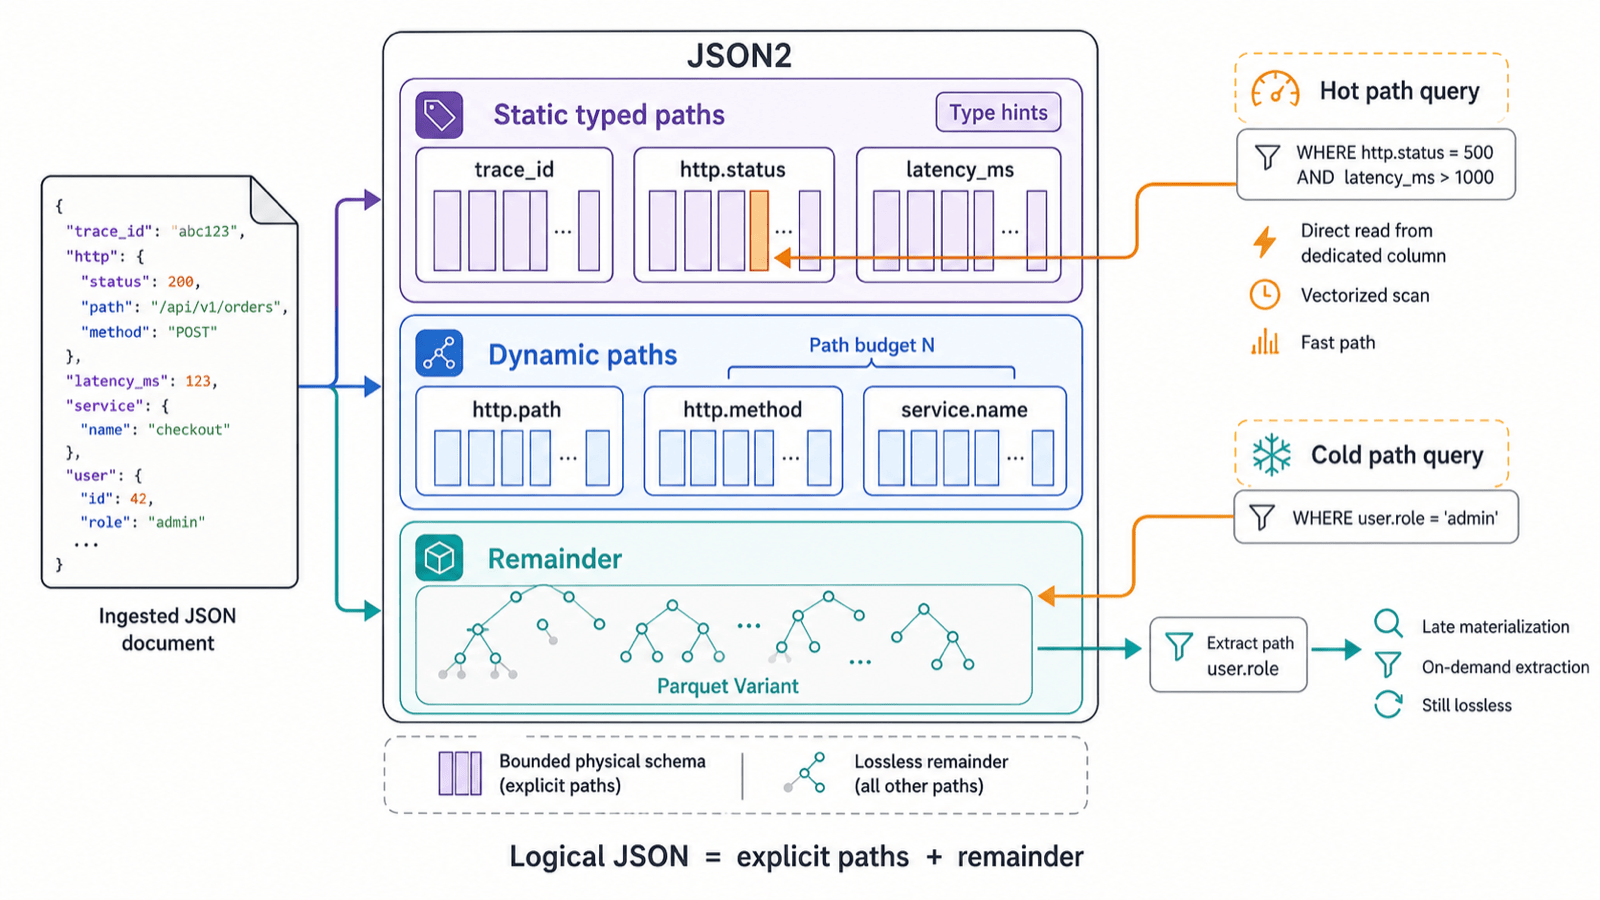
JSON2 的存储思路是把 JSON path 在合理范围内展开成独立的列,尽量利用 GreptimeDB 的列式存储和查询引擎。
列式化的代价:每条 JSON path 都可能成为一列
GreptimeDB 的存储引擎基于 Arrow 和 Parquet,两者都建立在静态 schema 之上:一个 Arrow StructArray 中的所有行共享同一组字段,一个 Parquet 文件要在 footer 中写下确定的列定义。JSON 则允许 path 随数据出现和消失,同一 path 的值甚至可以改变类型。JSON2 首先要解决的就是如何在静态容器中表达动态结构。
最直接的做法是 shredding:把每条 JSON path 变成一个可以单独读取的列。例如:
json
{"kind":"post","record":{"text":"hello"}}
{"kind":"like","record":{"subject":"at://example/post/1"}}
在一个 SST 中可以形成这样的物理结构:
text
Struct<
    kind: Utf8,
    record: Struct<
        subject: Utf8,
        text: Utf8
    >
>
查询 record.text 时,存储引擎只读取对应的 Parquet 列,不需要解析或反序列化完整的 JSON。不同的列可以分别压缩,过滤和聚合也能直接走向量化执行。
shredding 解决了读取效率,但没有回答最多可以拆出多少列。如果 JSON 只有少量稳定字段,自动展开所有 path 很有效;JSONBench 这类真实数据却可能有成千上万条 path,单行只包含其中很小一部分。每出现一条新 path,Arrow 要增加字段,Parquet 要增加列,两者的 schema 很容易膨胀到无法维护的规模。
这样保存 JSON,成本取决于整个数据集出现过多少条 path,而不只是每行实际写入多少值。JSON path 的数量没有上限,物理 schema 必须有上限。
JSON2 目前的做法是有上限的自动 shredding:单独成列的 path 数量有一个上界,物理 schema 不会无限增长。超过上界的 path 由下一节的分层存储处理。
分层存储:热点 path 独立成列,长尾 path 进入 remainder
JSON 存储格式要同时支持两种访问方式:常用 path 走独立列,读性能稳定;其余 path 进入一个有界的共享区域,任何新字段都能写入,Arrow 和 Parquet 的 schema 也不会无限扩张。
JSON2 把 path 分为三层:
Static typed paths:由 type hint 显式声明,通常是类型稳定、查询频繁的 path,始终拥有独立的 Parquet 列;
Dynamic paths:在预算内自动展开的 path,提供额外的列式加速,但不保证全局固定;
Remainder paths:超出预算的长尾字段,统一写入标准的 Parquet Variant,保留原始层级和值类型。
物理结构可以理解为:
text
Struct<
    static typed fields,
    dynamic fields,
    remainder: Variant
>
自动展开的 dynamic path 上限,也就是"预算",由 max_auto_expanded_paths 控制,默认值为 100。它写在 JSON2 列定义的括号里,和 type hint 放在一起:
sql
attrs JSON2 (
    max_auto_expanded_paths = 0,
    trace_id STRING
)
预算为零时,只有用户通过 type hint 声明的 path 独立成列,其余数据全部进入 remainder;预算为 N 时,系统最多再展开 N 条 dynamic path。
remainder 使用的是 Parquet 的 Variant 类型,和旧的 JSONB 是两种格式。Variant 可以在一个有界的列中保存不同结构和类型的值;代价是查询冷门 path 时,要先读取 remainder 再提取目标值。JSON2 目前接受这部分 cold path 成本,换来三个性质:物理 schema 有上限,长尾字段不丢失,热点 path 仍然可以下推到 Parquet。
在 GreptimeDB 1.2 中,type hint 和预算只能在建表时设置。修改已有 JSON2 列设置的 ALTER TABLE ... MODIFY COLUMN 语法已经合入主干(#9029),1.2.x 尚未包含;支持之后,业务变化后需要频繁读取的冷门 path 可以改为 static typed path。
无论一条 path 落在哪一层,static typed fields、dynamic fields 和 remainder 三者的并集都是完整的 JSON,且两两没有交集。
Query type concretize:由查询决定需要的结构
分层存储回答了 JSON 怎么存,查询引擎还需要知道怎么取。查询引擎通常从表的 schema 出发制定查询计划。要结构化地读取 JSON,JSON 的结构应当体现在表的元信息里;但 JSON 的结构是动态的,很难在静态的表元信息中一致地表示。
JSON2 的做法是直接从 SQL 中推导查询计划需要的 JSON 结构化类型,我们称之为 query type concretize。查询引擎从 SQL 中收集两类信息:
查询访问了哪些 JSON path;
每条 path 期望返回什么 SQL 类型。
例如:
sql
SELECT data.commit.collection FROM bluesky WHERE data.time_us > 1720000000000000;查询引擎可以推导出这条查询只需要 commit.collection 和 time_us,前者可以是字符串,后者要参与整数比较。因此 data 列的 JSON 结构化类型是:
text
Struct<
    time_us: Int64,
    commit: Struct<
        collection: Utf8,
    >
>
查询引擎只需要这个类型的 JSON 数据就能完成查询;存储引擎拿到这个类型后,可以按需读取 SST 中对应 path 的列。
Query type concretize 的类型完全来自 SQL 表达式,这是它的根本限制。对类型本来就不固定的动态数据,某行的实际值转换不到推断出的类型时返回空值,这是合理的行为。问题在于推断本身可能出错。还是上面的 SQL,如果不小心写成:
sql
SELECT data.commit.collection + 1 FROM bluesky WHERE data.time_us > 1720000000000000;+ 1 会让查询引擎把 commit.collection 推断为数值类型,而它的实际值都是字符串,这条查询得不到有意义的结果。type hint 用来处理这种情况。
Type hint:为 JSON path 固定类型
建 JSON2 列时,可以为指定的 JSON path 声明固定类型。下面的建表语句中,attrs 这个 JSON2 列有 4 个 path type hint:
sql
CREATE TABLE application_logs (
    ts TIMESTAMP TIME INDEX,
    attrs JSON2 (
        trace_id STRING,
        http.status BIGINT,
        latency_ms DOUBLE,
        error BOOLEAN DEFAULT false
    )
) WITH (
    append_mode = 'true'
);
JSON2 列要求表开启 append_mode = 'true',否则建表会报错。
Type hint 是静态信息,保存在表的 schema 中。查询引擎推断 JSON 的结构化类型时以 type hint 为依据。下面这条查询中,attrs.http.status 按 type hint 读取为 BIGINT,再和整数 200 比较:
sql
SELECT attrs.trace_id FROM application_logs WHERE attrs.http.status = 200;声明了 type hint 的 JSON path 固定放在 JSON2 的 static typed paths 中(见上文"分层存储"一节),拥有独立的存储列,读性能最好。类型稳定、查询中常用的字段,建议都加上 type hint。
Type hint 也有代价:对声明了 type hint 的字段,JSON2 会拒绝写入类型不符的数据。例如把 http.status 写成字符串:
sql
INSERT INTO application_logs VALUES
(3, '{"trace_id":"8f3a1e","http":{"status":"oops"},"latency_ms":1.0}');
写入会失败,报错为:
text
Invalid JSON: JSON value at http.status does not match JSON2 type hint Int64SQL 语法:像访问普通结构一样访问 JSON
JSON2 最直接的访问方式是 dot syntax:
sql
SELECT
    attrs.trace_id,
    attrs.http.status,
    attrs.latency_ms
FROM application_logs
WHERE attrs.http.status >= 500;
JSON path 可以出现在 SELECT、WHERE、GROUP BY 和普通表达式中,比较和算术运算也会为 query type concretize 提供期望类型。
需要精确控制返回类型、避免无效查询时,可以用 json_get 加 cast:
sql
SELECT
    json_get(attrs, 'http.path')::STRING AS path,
    AVG(json_get(attrs, 'latency_ms')::DOUBLE) AS avg_latency_ms
FROM application_logs
GROUP BY json_get(attrs, 'http.path')::STRING;
两种语法的查询能力相同:dot syntax 适合固定、可读的字段路径,json_get 适合显式类型转换和程序生成的查询。
一个完整示例:
sql
CREATE TABLE application_logs (
    ts TIMESTAMP TIME INDEX,
    attrs JSON2 (
        trace_id STRING,
        http.status BIGINT,
        latency_ms DOUBLE,
        error BOOLEAN DEFAULT false
    )
) WITH (
    append_mode = 'true'
);

INSERT INTO application_logs VALUES
(
    1,
    '{"trace_id":"8f3a1c","http":{"method":"POST","path":"/v1/orders","status":200},"latency_ms":42.8}'
),
(
    2,
    '{"trace_id":"8f3a1d","http":{"method":"POST","path":"/v1/orders","status":500},"latency_ms":71.2,"error":true}'
);

SELECT
    attrs.http.path AS path,
    COUNT(*) AS requests,
    SUM(CASE WHEN attrs.error THEN 1 ELSE 0 END) AS errors
FROM application_logs
GROUP BY attrs.http.path;
预期结果:
text
+------------+----------+--------+
| path       | requests | errors |
+------------+----------+--------+
| /v1/orders |        2 |      1 |
+------------+----------+--------+
path 和 error 都是 JSON 内部字段,filter 和 group by 拿到的是具体的 SQL/Arrow 类型的值,不需要逐行完整反序列化 JSONB。
总结与下一步
JSON2 让 GreptimeDB 可以结构化地存取 JSON:声明了 type hint 或被自动展开的 path,读取方式和普通列相同。它适合可观测场景中的日志和 trace 数据。
GreptimeDB 目前在 JSONBench 上的成绩,来自在 ingestion pipeline 中把常用 JSON path 直接展开为表列。这种做法分析性能很好,但不再保留原始 JSON 的层级结构,因此在 JSONBench 中被标记为 "flatten",这是为了性能做的妥协。在我们最新的测试中,JSON2 在 JSONBench 上已经追平此前的实现。JSON2 的读性能还在继续优化,提交新的 JSONBench 成绩后,我们会再发一份单独的性能对比报告。


