本页内容

背景
某卫星科技公司是一家民营航天企业,为卫星通信、雷达及终端设备等太空科技领域提供产品与解决方案。卫星研发的各个阶段都会持续产生带时间戳的数据:设备状态、仿真结果、测试和试验数据,还有研发平台自身的指标和日志。卫星研发过程中可能要做几十到上百次数据实验,单次实验用到的数据可达 30 多亿行,甚至更多。
该公司最早用 InfluxDB 2.x 存储这些数据。数据量和实验数量增长以后,查询经常 OOM,单机版本又无法扩展,Bucket 数量、Flux 查询、技术支持和软件许可也都成了限制。评估过 ClickHouse、VictoriaMetrics 和 GreptimeDB 之后,该公司选择了 GreptimeDB。目前 GreptimeDB 以私有化方式部署,卫星业务指标和日志都已写入 GreptimeDB,InfluxDB 的历史数据也已迁移过来。
迁移之后,平台设计不再受 InfluxDB 的限制。实验数据可以按需分库,不用再顾虑 Bucket 数量;指标和日志都存在 GreptimeDB 里,用同一套 SQL 就能做统一分析;数据量继续增长时,可以从单机部署扩展到集群,GreptimeDB 开源版就支持分布式部署。
InfluxDB 的限制
研发早期,InfluxDB 对该公司最有用的一点是数据可以先写进去,Schema 之后再考虑。卫星研发的数据来自不同型号、实验和测试环境,早期还有大量临时数据,字段很难提前定好。
数据规模扩大以后,重新选型的原因主要有六个:
- 查询 OOM,无法扩展。 单次实验的数据可达 30 多亿行甚至更多,查询经常因内存不足失败。InfluxDB 开源版只能单机运行,集群和高可用需要购买商业版,单机资源用满后没有扩展的余地。
- Bucket 数量。 InfluxDB 2.x 以 Bucket 作为数据组织和保留策略的单位。该公司按实验划分数据、分别设置保留期,几十上百次实验对应几十上百个 Bucket。InfluxDB 官方文档写明,单个开源版实例大约支持 20 个同时读写的 Bucket,再多可能影响性能。
- Flux。 查数据的人包括软件研发、测试、算法、仿真和平台人员,大多数人熟悉的是 SQL。多学一门 Flux,能自己分析数据的人就少了。
- 技术支持。 使用 InfluxDB 期间没有可用的技术支持,出了问题只能自己排查。
- 新版本的限制。 新一代的 InfluxDB 3 Core 对数据规模有硬限制:最多 5 个 database,所有 database 合计 2000 张表,每张表 500 列,这和按实验分库、按对象建宽表的用法冲突。
- 国产化替代的诉求。 该公司服务的客户看重基础软件国产化,这也是重新选型的原因之一。
接入层:Vector 和字段前缀约定
数据通过一套修改过的 Vector 接入。OpenTelemetry 指标写入 InfluxDB 时,默认每个指标名对应一个 Measurement,数据会分散到大量 Measurement 里;而卫星研发数据常见的情况是同一个对象在同一时刻产生大量参数,平台团队希望这些参数按对象写进一张宽表。为此他们在 Vector 里实现了 Schema Mapping 规则:
tag_前缀的字段映射为 Tag,field_前缀的字段映射为 Field;- 同一个 Measurement Name 下的数据合并写入同一张物理宽表。
text
tag_satellite_id
tag_experiment_id
field_temperature
field_voltage
field_current
研发人员按约定发送数据,不需要了解底层数据库如何组织数据。这套做法也成了选型的一条标准:数据库要允许平台做 Schema 治理,研发阶段的数据又能自由写入。
选型
ClickHouse 性能和生态都很好,但数据写入前通常要设计表结构、排序键和分区。该公司有大量临时实验数据,有的实验只持续几天,字段还在变化。如果每次实验前都要先定 Schema 再建表,实验流程就多了一步。
VictoriaMetrics 主要面向指标。该公司除了卫星业务指标,还要把日志、Traces 和研发过程数据放到同一套基础设施上,不想为每类数据各维护一套系统。
GreptimeDB 满足了几项关键要求:
- 面向时序场景,指标、日志和 Traces 统一存储;
- 开源版支持从单机扩展到分布式集群;
- 支持 SQL,研发人员不用再学新的查询语言;
- 正式数据可以按平台规范建表,临时数据写入时自动建表、自动加列;
- Apache 2.0 开源,由国内团队开发,遇到问题可以直接联系 Greptime 研发团队,也可以升级采购企业版。
现在的用法
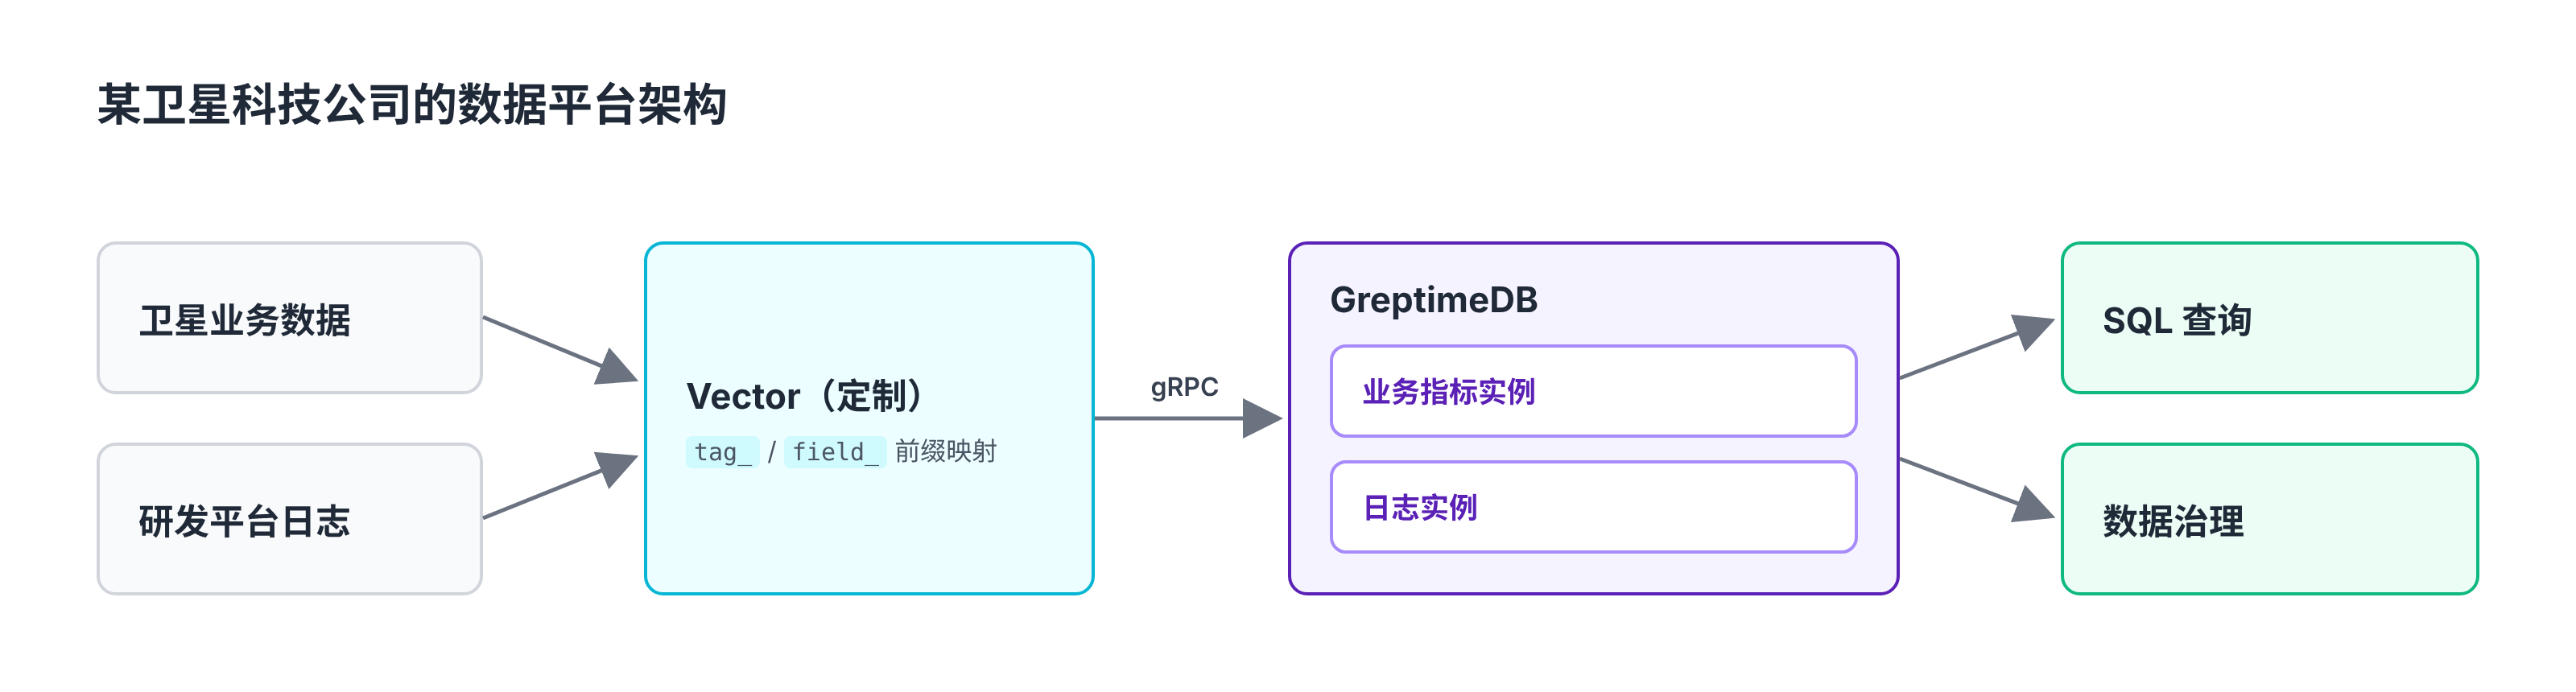
修改过的 Vector 通过 GreptimeDB gRPC 协议写入。数据按 database 划分,每个 database 内的表使用统一的 TTL,原来由 Bucket 承担的数据隔离和保留策略,改由 database 加 TTL 实现。
数据分两类处理。长期保存的卫星业务指标、实验结果等正式数据,按平台定义的 Data Contract 和 Schema 写入标准化表。临时实验数据由发送方指定表名,GreptimeDB 收到后自动建表,后续出现新字段时自动加列,同一个对象上报的 temperature、voltage、current 等字段会形成一张以时间为主轴的宽表。研发人员加一个字段,不需要提建表申请,也不用等平台团队改 Schema。
查询直接用 SQL:
sql
SELECT *
FROM experiment_xxx
WHERE ts BETWEEN '<开始时间>' AND '<结束时间>'
ORDER BY ts;
研发人员只需要知道数据在哪张表,不用再理解 Measurement、Bucket 和 Flux。
在 GreptimeDB 之上,平台团队还建了一层数据治理,负责字段命名规范、Tag / Field 识别、类型校验、高基数字段控制、Data Contract、Schema 变更记录、数据血缘和数据质量检查。GreptimeDB 负责存储和查询,治理逻辑留在平台层。
后续计划
目前卫星业务指标和日志分在两个实例上,后续在两边数据里加上统一的关联 ID,就可以把卫星状态和对应的日志放在一起分析。应用和基础设施指标、CI/CD 指标、Traces、仿真和测试数据也会逐步接入,让可观测性、实验数据、数据质量等上层平台共用同一套存储和治理能力。
该公司的做法是确定的数据做治理,不确定的数据保留探索空间。迁移到 GreptimeDB 之后,研发人员可以直接写入数据、用 SQL 查询;平台团队的精力从帮各个项目维护数据库,转到了数据标准和数据质量上。
本文基于对该公司产研团队的采访撰写,在此表示感谢。
延伸阅读
- GreptimeDB vs. InfluxDB 性能测试报告:对比 InfluxDB 2.7.7,GreptimeDB 写入吞吐是其 2 倍以上,大数据量查询最高快 11 倍以上;写入 11.5 亿行时,InfluxDB 开源版因
cache-max-memory-size exceeded未能完成写入。 - GreptimeDB v1.2 vs InfluxDB 3.11:读写性能与存储空间对比:对比 InfluxDB 3.11 Core 和 Enterprise,GreptimeDB 写入吞吐分别是二者的 1.49 倍和 1.31 倍;InfluxDB 3 Core 在 groupby-orderby-limit 和 lastpoint 两类查询上 OOM。
- 请查收!从 InfluxDB 到 GreptimeDB 迁移指南
- 阿里云 InfluxDB 版 10 月退市:迁移方案与专项支持


