本页内容

业务同时跑在多朵公有云、多个地域和不同的合规边界内时,“把数据拉回中心再分析”的可观测性架构会遇到四个问题:跨云网络费用随数据量持续上涨,跨云查询拖慢排障,部分原始数据按合规要求不能出域,中心集群本身成为性能瓶颈和单点故障。
这篇文章从 OceanBase Cloud(下称 OB Cloud)的生产实践出发,讨论多云环境下的可观测性数据库怎么设计:数据在哪里落盘,查询在哪里执行,对象存储怎样成为数据库的一部分,以及系统如何同时满足成本、性能、自治和统一体验的要求。我们的结论是:多云架构要做的是统一管理分布在各朵云里的数据,对用户提供一致的使用体验,同时让每朵云的集群保持本地自治,不需要把所有数据集中到一处。
OB Cloud:七朵云上的生产环境
OB Cloud 从 2022 年起提供一体化多云数据库服务,目前覆盖 7 朵主流公有云、16 个国家和地区、60 多个 Region、240 多个可用区,支持跨地域、跨云容灾。
云数据库要给用户一致的体验,可观测性系统就要跟着业务部署到每一朵云:日志按合规要求不能随意出域,排障时又不能让工程师在七套互不相通的工具之间切换。
四类日志,同一对矛盾
OB Cloud 要同时处理应用日志、OBServer 日志、OBProxy 日志和 SQL Audit。四类日志的写入量、字段结构、保留周期和查询模式各不相同,故障排查时又需要关联分析。
在 OB Cloud 的生产观察中,这些日志约 95% 的时间不会被查询;故障发生时,工程师又需要立即搜索数小时甚至数天的数据。平时要压低长期存储成本,出事时要快速找到有用的那几条记录,两个要求同时存在。
每接入一朵云,都要重新适配一次
阿里云、华为云、腾讯云、百度智能云、AWS、Azure 和 Google Cloud 的日志产品,在采集端、查询语言、身份权限和对象存储接口上都有差异:
| 云日志服务 | 典型采集端 | 查询语言 |
|---|---|---|
| 阿里云 SLS | Logtail / LoongCollector | Lucene + SQL |
| 华为云 LTS | ICAgent | 类 Lucene |
| 腾讯云 CLS | LogListener | 类 Lucene |
| 百度云 BLS | LogAgent | 类 Lucene + SQL |
| AWS CloudWatch | CloudWatch Agent | Logs Insights |
| Azure Monitor | Azure Monitor Agent | KQL |
| GCP Logging | Ops Agent / Fluent Bit | Logging Query Language |
如果可观测性平台直接建在各云的日志服务之上,每接入一朵云就要重做一次适配;在七种查询语法之上再抽象一层统一 API,长期维护成本同样很高。
第一代方案:Loki 降低了存储成本,查询窗口只能缩到分钟级
OB Cloud 的第一代方案用 Grafana Loki:标签索引加对象存储,存储成本降了下来,也能直接接入 Grafana。Loki 只索引标签,不索引日志正文。按正文关键字检索时,大范围查询需要扫描大量数据,经常超时,日志查看页的默认查询窗口只能设到几分钟。
日志大部分时间不被访问、故障时又必须马上能搜,这时候瓶颈已经从采集链路转到了数据库:它要在低成本存储和高效检索之间做取舍。
迁移到 GreptimeDB 之后
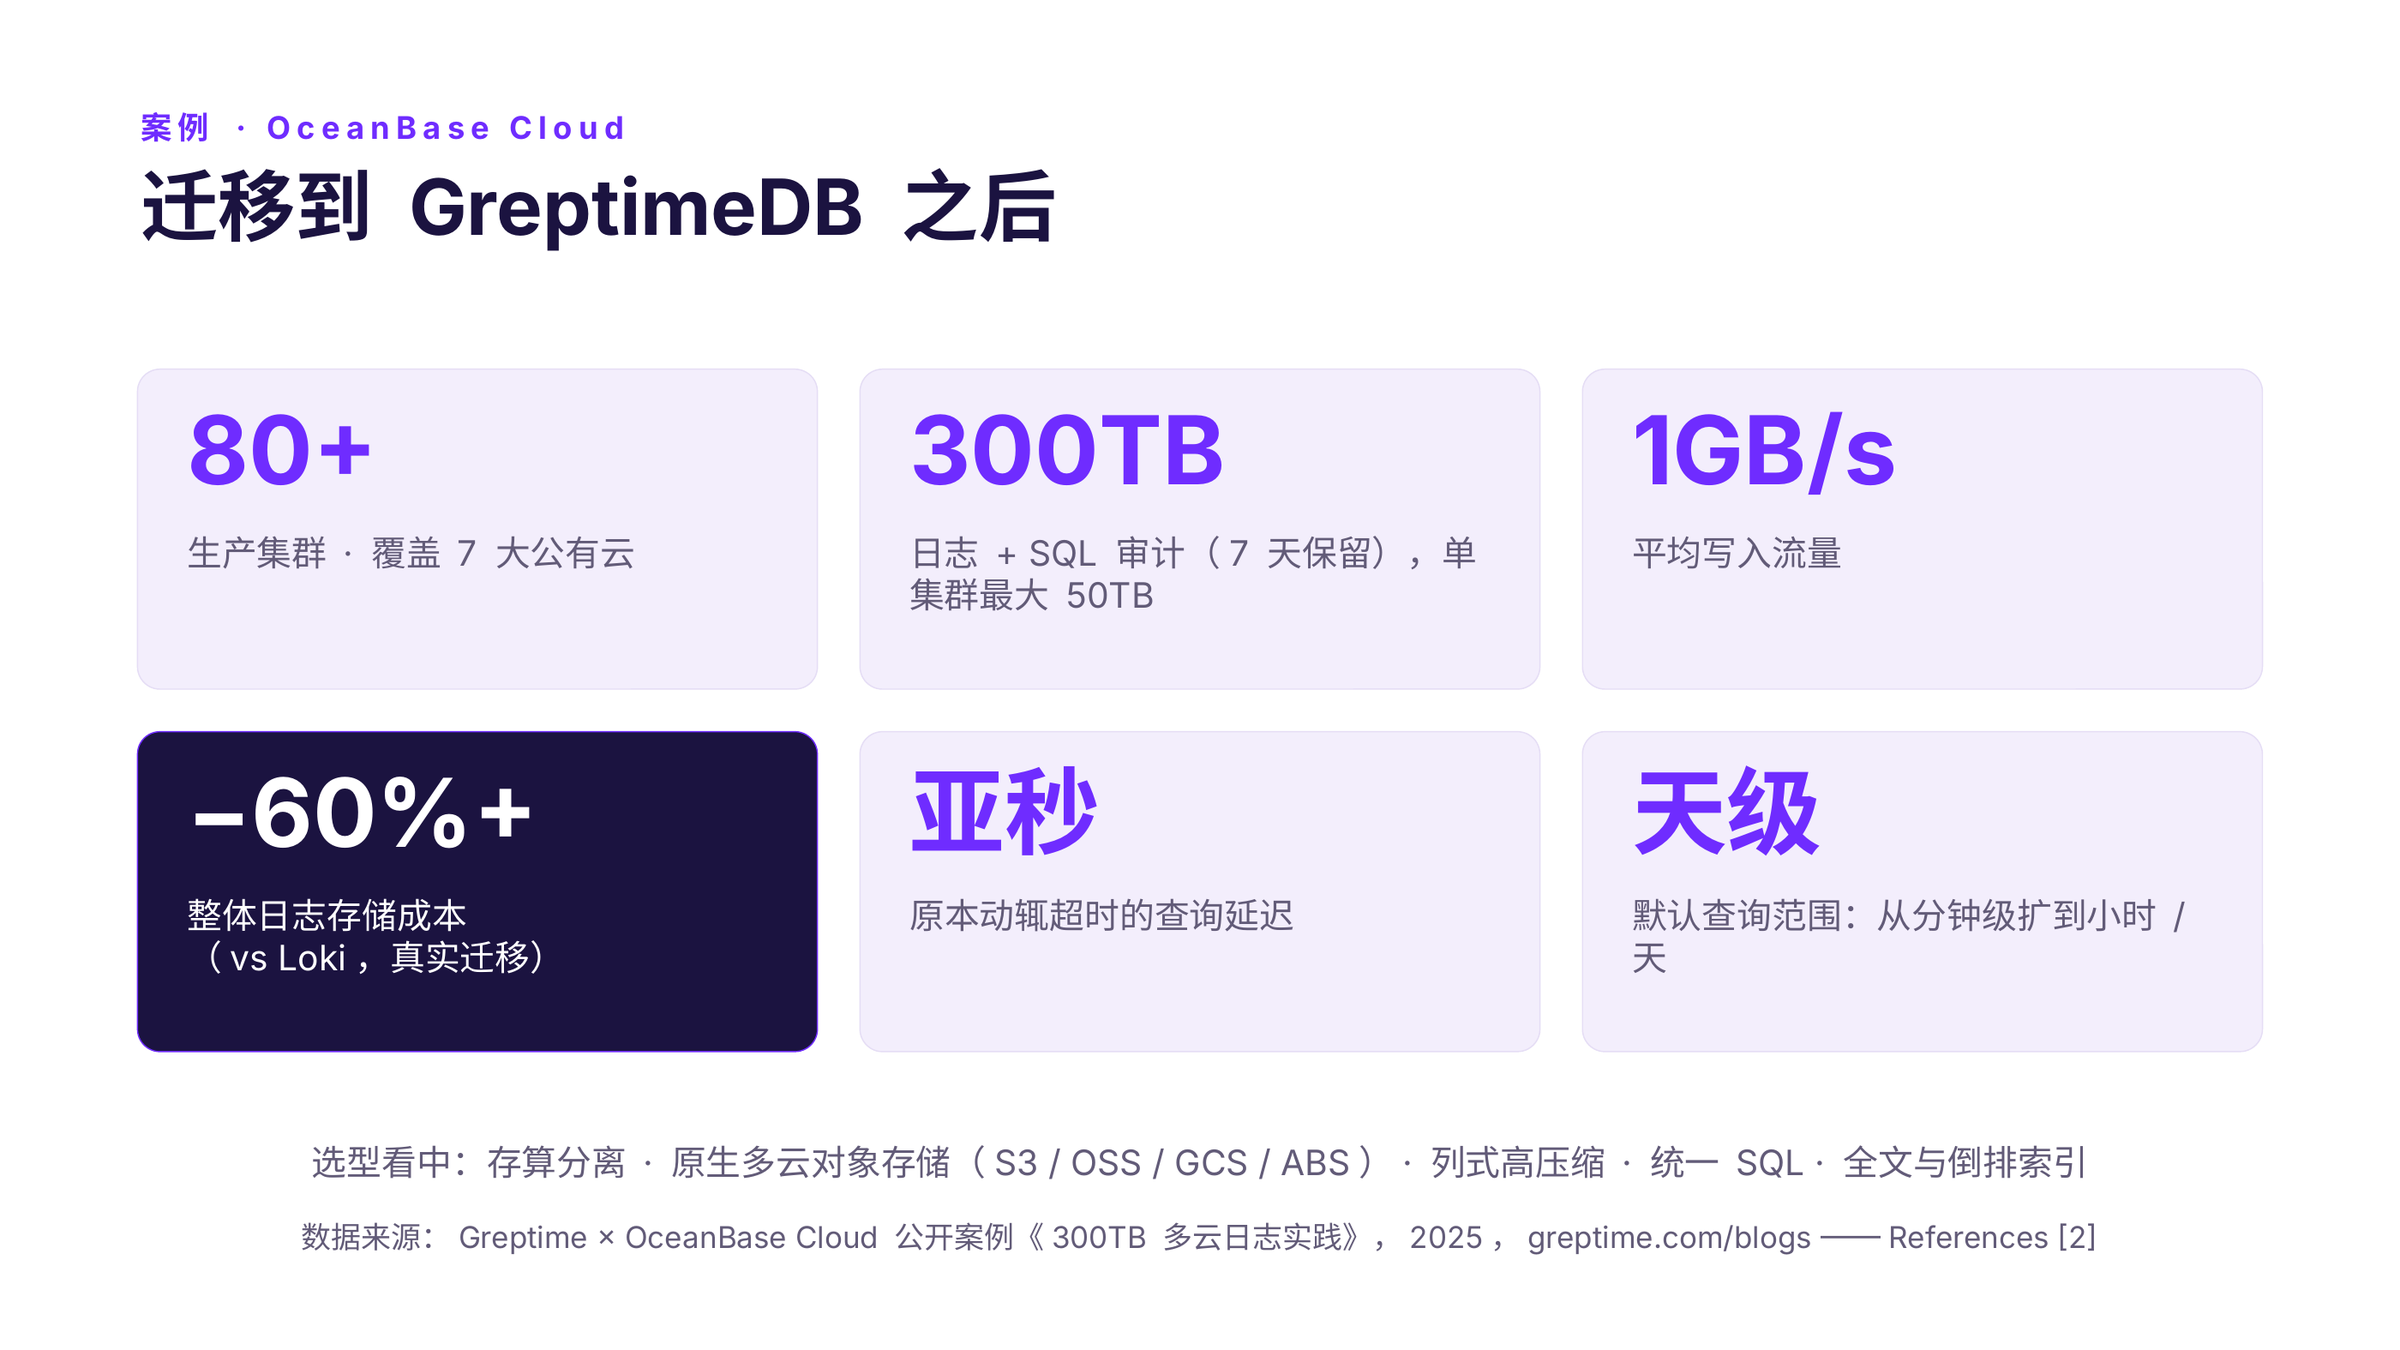
迁移到 GreptimeDB 后,OB Cloud 在 7 朵公有云上运行 80 多个生产集群,7 天保留周期下存有 300TB 以上的日志与 SQL 审计数据,单集群最大 50TB,平均写入流量约 1GB/s。和原来的 Loki 方案相比,整体日志存储成本下降 60% 以上;原来容易超时的查询降到亚秒到秒级,默认查询范围从分钟扩展到小时乃至天。
完整的迁移过程见 OB Cloud 用户案例。
迁移过程中,真实负载暴露的问题先后推动了 GreptimeDB 的几轮改进:
- v0.15 支持 Pipeline 按日志级别和关键词过滤,在写入时丢弃不需要的日志;
- v0.13 引入新的全文索引实现和查询函数,查询写法更简单,性能也更好;
- v0.15 调整 Compaction 的文件合并策略,降低合并时的峰值内存,解决高写入下 Datanode OOM 的问题;
- v0.15 让 Metasrv 完整支持 RDS 作为元数据存储,并提供迁移工具,OB Cloud 不再需要额外维护 etcd;
- 企业版的自动扩缩容、自动分区、负载均衡、分层缓存和智能流控进入生产。
日志之外,OB Cloud 目前正在把 SkyWalking 的后端存储切换到 GreptimeDB,让链路和 APM 数据与日志在同一套系统里统一存储和处理,并提供给 SRE Agent 使用。目前使用的是支持 GreptimeDB 存储的 SkyWalking fork 版本:killme2008/skywalking。
多云改变的是数据边界和查询边界
持续产生高吞吐观测数据的多云系统,都会遇到和 OB Cloud 相同的五个瓶颈:
- **跨云传输成本高。**高吞吐数据长期跨云搬运,网络费用和传输时间都会快速增长。
- **远程集中查询延迟高。**每次跨云网络往返都在消耗排障时间。
- **数据驻留与合规受限。**数据主权要求可能禁止原始日志离开本地或特定区域。
- **单中心压力和风险过大。**一个中心承载所有写入和查询,既是性能瓶颈,也是单点故障。
- **各云基础设施有差异。**对象存储 API、网络、IAM 和 Kubernetes 环境不完全一致,部署方案不能直接复制。
所以多云可观测性要放弃“全部拉回中心”的假设,重新划定两条边界:原始数据在什么范围内流动,查询在哪一层完成。
总体架构:逻辑统一,物理分布
面向多云的可观测性数据库分成三层:全局层、每云集群和存储面。设计的重点是明确每一层的职责和故障边界,不用一个控制面横跨所有云。
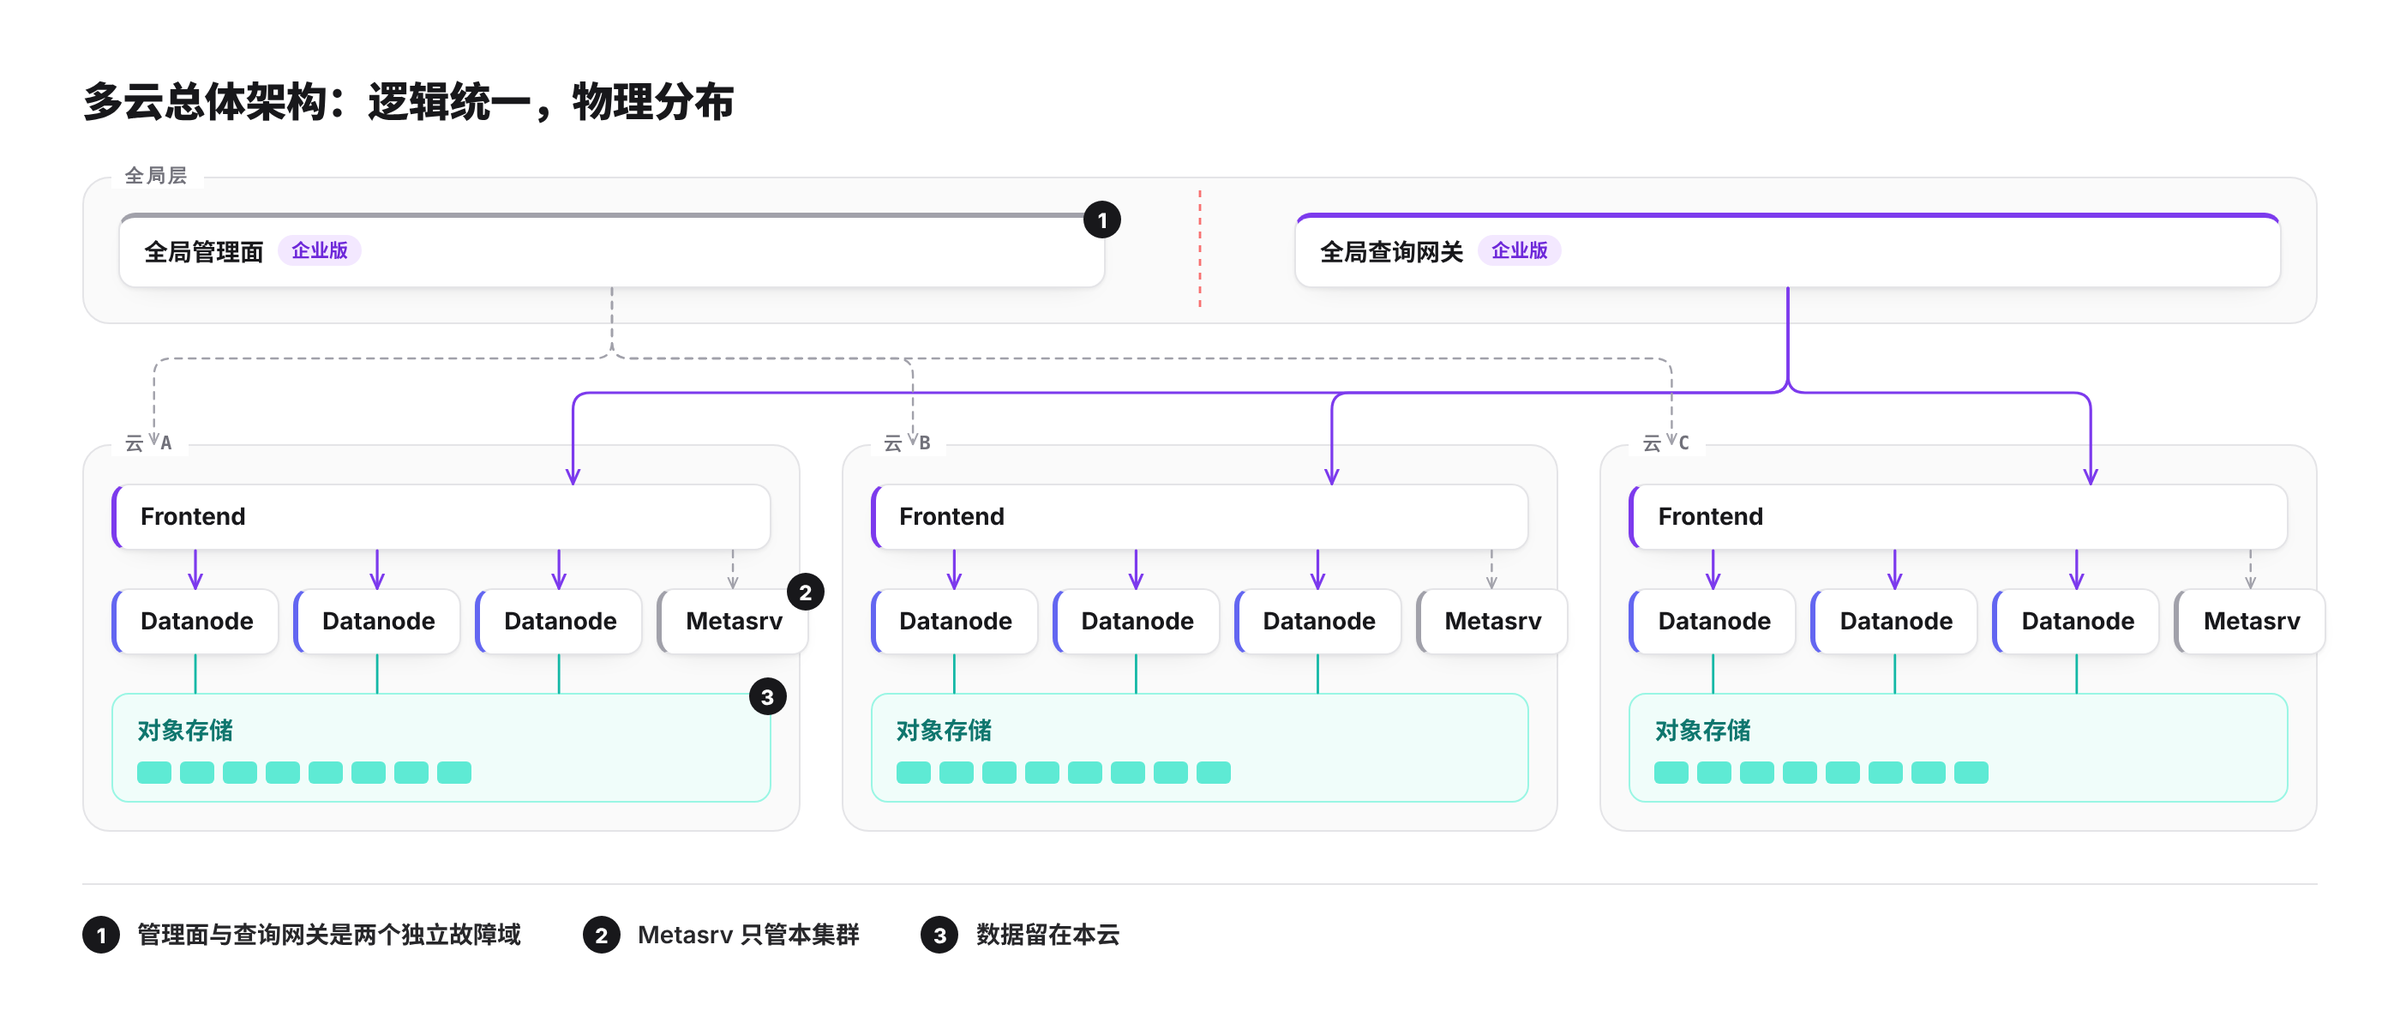
| 层次 | 主要职责 | 边界 |
|---|---|---|
| 全局管理面 | 租户、配额、审计、集群生命周期和统一运维入口 | 企业版能力;与全局查询网关是两个独立故障域 |
| 全局查询网关 | 统一查询入口、跨云路由和结果归并 | 企业版能力;不替代云内的查询规划 |
| 每云 GreptimeDB 集群 | 本地写入、查询、元数据与路由 | 完整自治;Metasrv 只管理本集群,不跨云 |
| 存储面 | 热、温、冷数据及其索引、生命周期和位置信息 | 数据尽量留在所属云和合规区域内 |
集群内部沿用 GreptimeDB 的职责划分:Frontend 负责协议入口、查询规划和结果汇总,Datanode 负责数据扫描和索引裁剪,Metasrv 维护元数据与路由。每朵云部署一套完整集群,彼此物理隔离、独立运行;全局层只负责统一的管理入口和访问入口。
存储按温度分层
- 热数据放在本地 SSD、云盘或缓存层,优先满足低延迟访问。
- 温数据放在 S3、OSS、COS、GCS、ABS、MinIO 或 HDFS 等对象存储上,配合索引控制查询代价。
- 冷数据进入归档存储或低频访问的对象存储,以更低成本满足长期保留。
- 元数据记录 Region、文件、索引、时间范围、生命周期和数据位置,是查询裁剪和路由的依据。
从存算分离到算算分离
传统 Shared-Nothing 架构把存储和计算绑定在同一组节点上,资源只能粗粒度分配,扩容往往伴随数据迁移。GreptimeDB 先把持久化数据放到对象存储,Frontend 和 Datanode 成为可以弹性扩缩的计算层;再按负载类型拆分计算资源,写入、在线查询、大范围分析和历史数据查询分别由不同角色的 Datanode 承担。
这样资源隔离的粒度更细:写入高峰不会拖慢在线查询,大范围分析也不会占用实时排障需要的算力。
写入路径:WAL 与 WAL-less
写入先进入本地 Frontend,由它完成租户识别、分片路由和自适应攒批。批次形成后,系统按负载选择两条路径之一:
- 常规 WAL 路径:数据写入 WAL 和 Memtable,之后 Flush 到对象存储。适合需要低延迟确认和通用恢复语义的场景。
- 企业版 WAL-less 路径:Frontend 把小批写入聚合成适合列式存储的大批数据,直接写入对象存储,省掉一次 WAL 写入及相关服务成本。面向持续的超大吞吐场景。
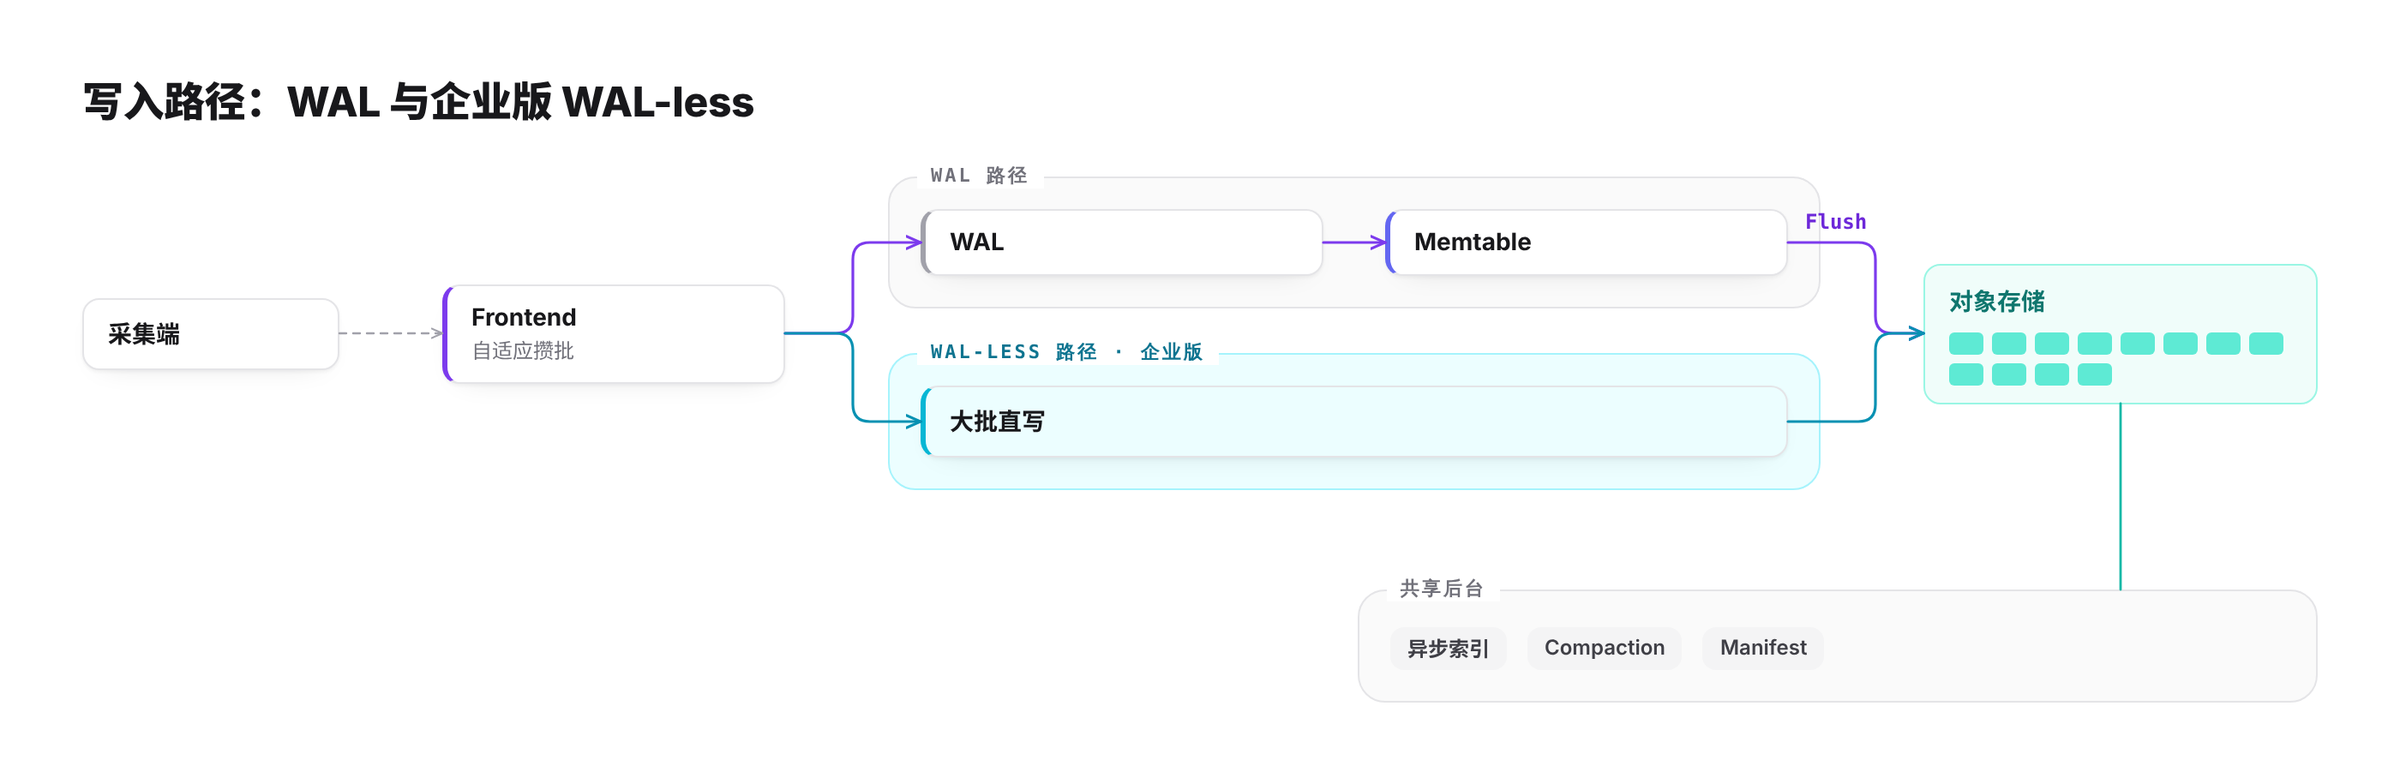
两条路径之后共享异步索引构建、Compaction 和 Manifest 管理。WAL-less 只用于持续超大吞吐的负载:它更直接地依赖对象存储的可用性,必须配合背压、缓冲和容量控制。对象存储异常时,WAL 路径可以先由 WAL 和 Memtable 短时缓冲;WAL-less 路径需要更早触发背压。
对象存储的四个特性
对象存储让容量和成本更有弹性,但它的行为和本地文件系统差别很大:
- 访问延迟更高,GET、PUT 等每次请求都单独计费;
- 修改 key 或路径通常意味着复制后再删除,没有廉价的重命名;
- 上传以整对象覆盖为主,不能像本地盘那样随机修改;
- LIST 操作昂贵,单次返回数量有限,不能把目录遍历当元数据系统用。
对象存储降低了介质成本,复杂度则转移到了写入、缓存、元数据和查询调度层,这些差异需要数据库自己处理。
写入走本地回写缓存,读取经过 IO 调度
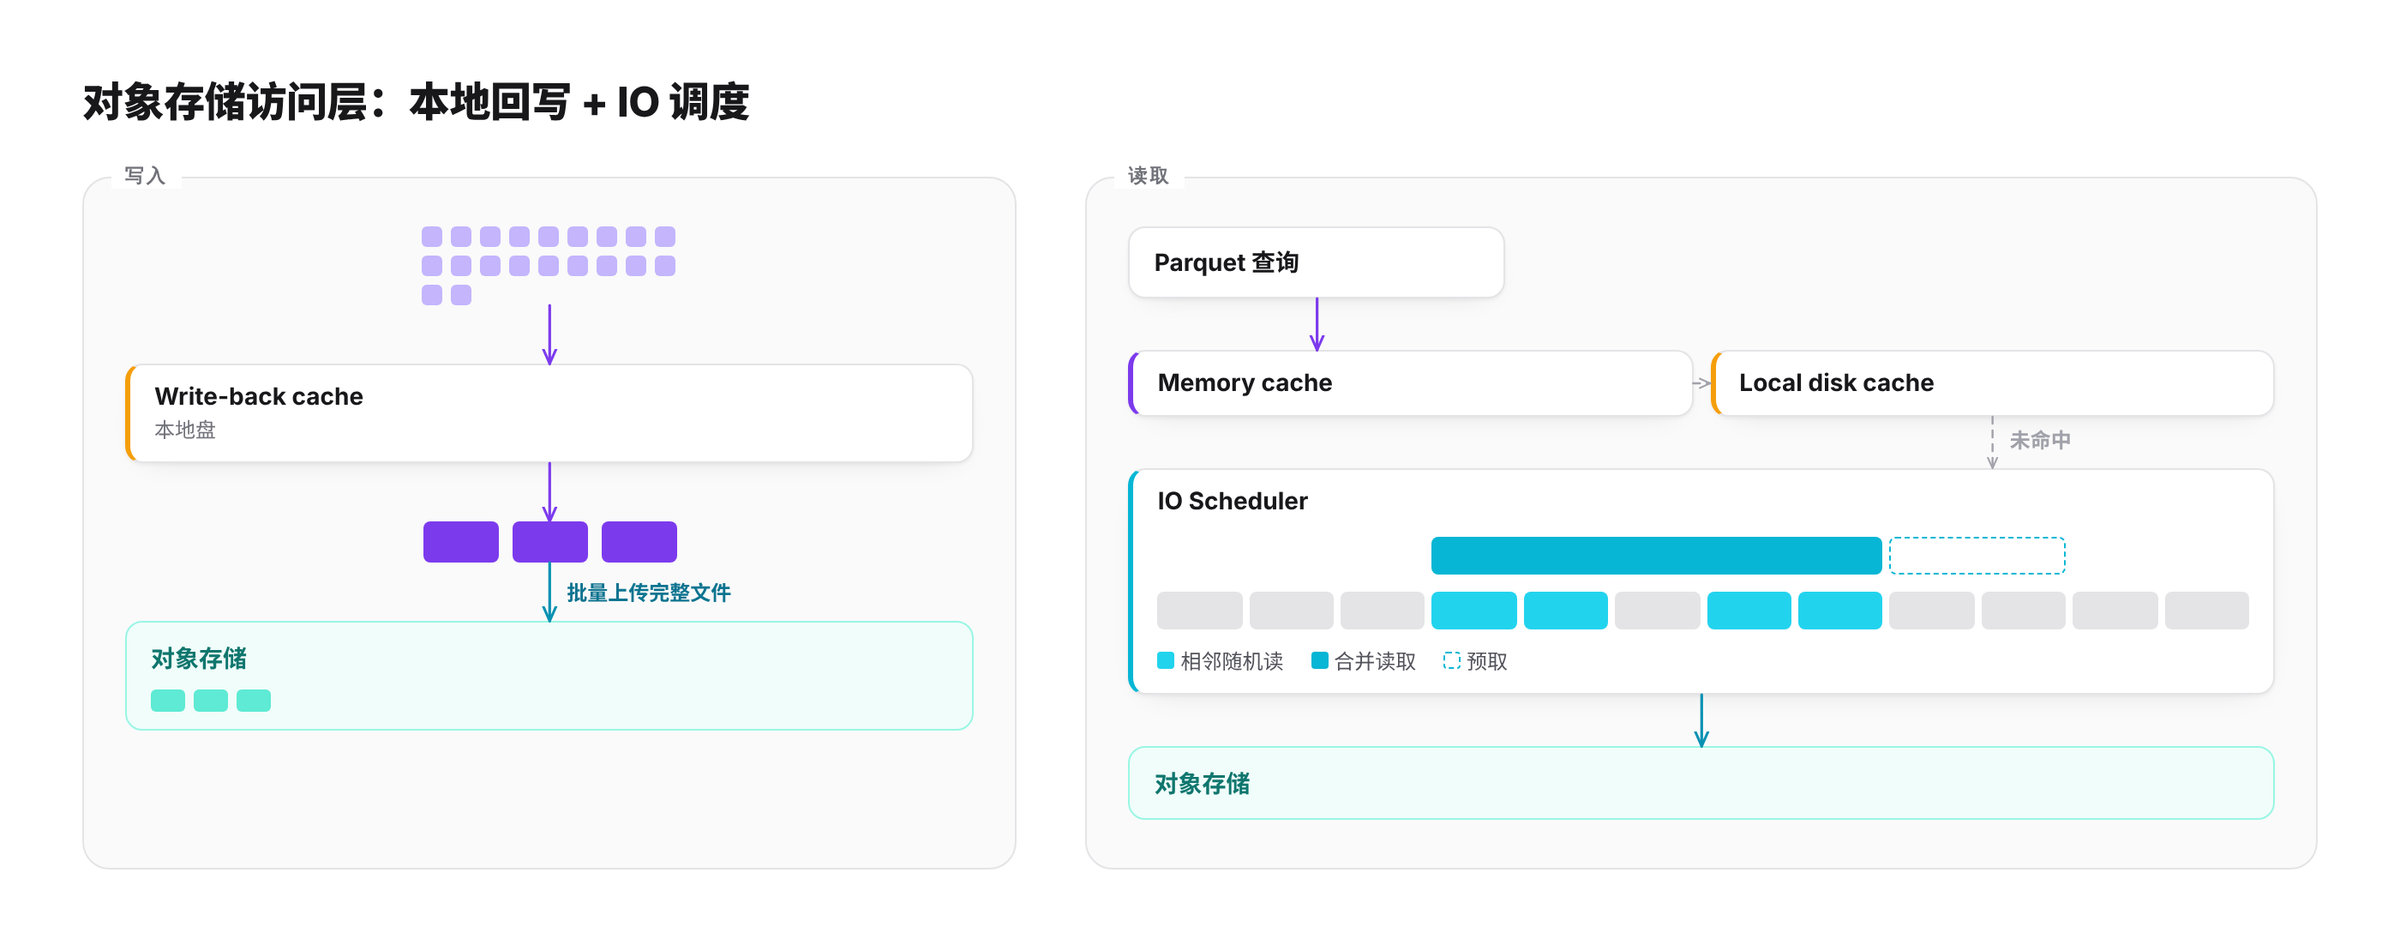
写入侧,数据先完整写入本地的 write-back cache,热路径在本地完成;后台任务再把完整文件批量上传到对象存储。Multipart upload 是上传手段之一,减少 API 调用次数主要靠回写缓存把大量零碎写入合并成数量更少、体积更大的对象。
读取侧,对象存储上的 Parquet 查询经常表现为多个相邻的小范围随机读。IO Scheduler 识别这些请求的位置关系,把相邻的随机 IO 合并成更大的连续读取,并根据 Parquet 的访问模式预取后续可能用到的数据块和元数据。内存和本地盘两级缓存承接热点数据、索引和元数据,减少对远端的请求次数,提高有效吞吐。
用 Iceberg 开放数据
数据进入对象存储后,还要能被其他计算引擎使用。企业版 Iceberg exporter 读取表、Region、Manifest 和 Parquet footer 中的统计信息,生成标准的 Iceberg Metadata;Iceberg DataFile 直接指向 GreptimeDB 原有的 Parquet 文件,不复制数据。
同一份底层数据,GreptimeDB 继续负责实时写入和在线查询,Spark、Trino 等引擎可以读取它做离线分析、数据加工或 AI 任务。以后更换或新增计算引擎,已有数据不用迁移。
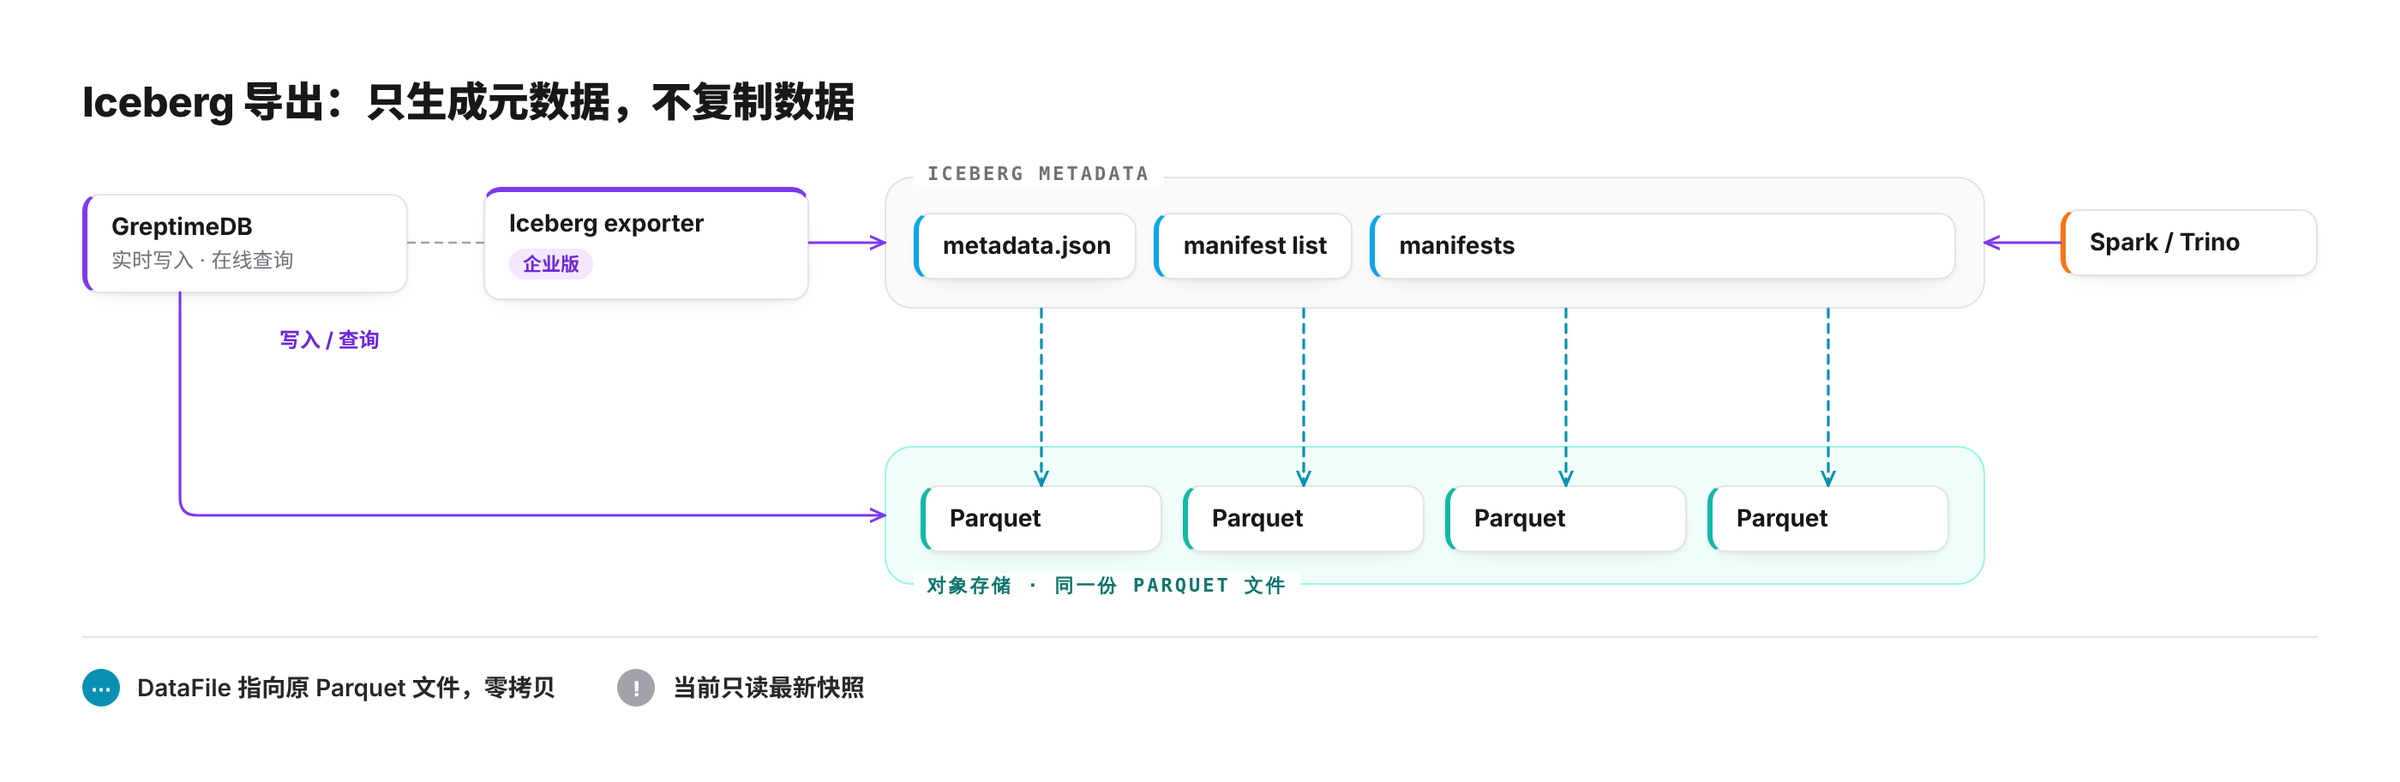
目前这项集成只支持读取最新快照,完整的 schema history 和 time travel 还在开发中。普通表、Dense 指标表和 Sparse 指标物理表的导出布局不同,外部引擎使用前需要核对当前版本的映射规则。
查询性能:分层索引与两级裁剪
索引预算按数据价值分配
日志查询通常同时包含时间范围、服务或实例过滤、关键词检索、结构化字段过滤、聚合统计和上下文追踪。给所有字段、所有数据都建全文索引,索引成本会比查询收益增长得更快。
我们按层建设索引:
- 时间索引:所有数据都有,用于最基础的范围裁剪。
- 标签索引:覆盖 service、host、namespace、pod 等高频过滤维度。
- 字段统计:用 MinMax、ZoneMap、NDV 等低成本统计快速缩小范围。
- Bloom Filter:快速排除确定不包含目标值的数据块。
- 倒排与全文索引:只对关键字段、热数据或高价值租户启用。
- 列式存储与统计信息:服务结构化过滤和聚合分析。
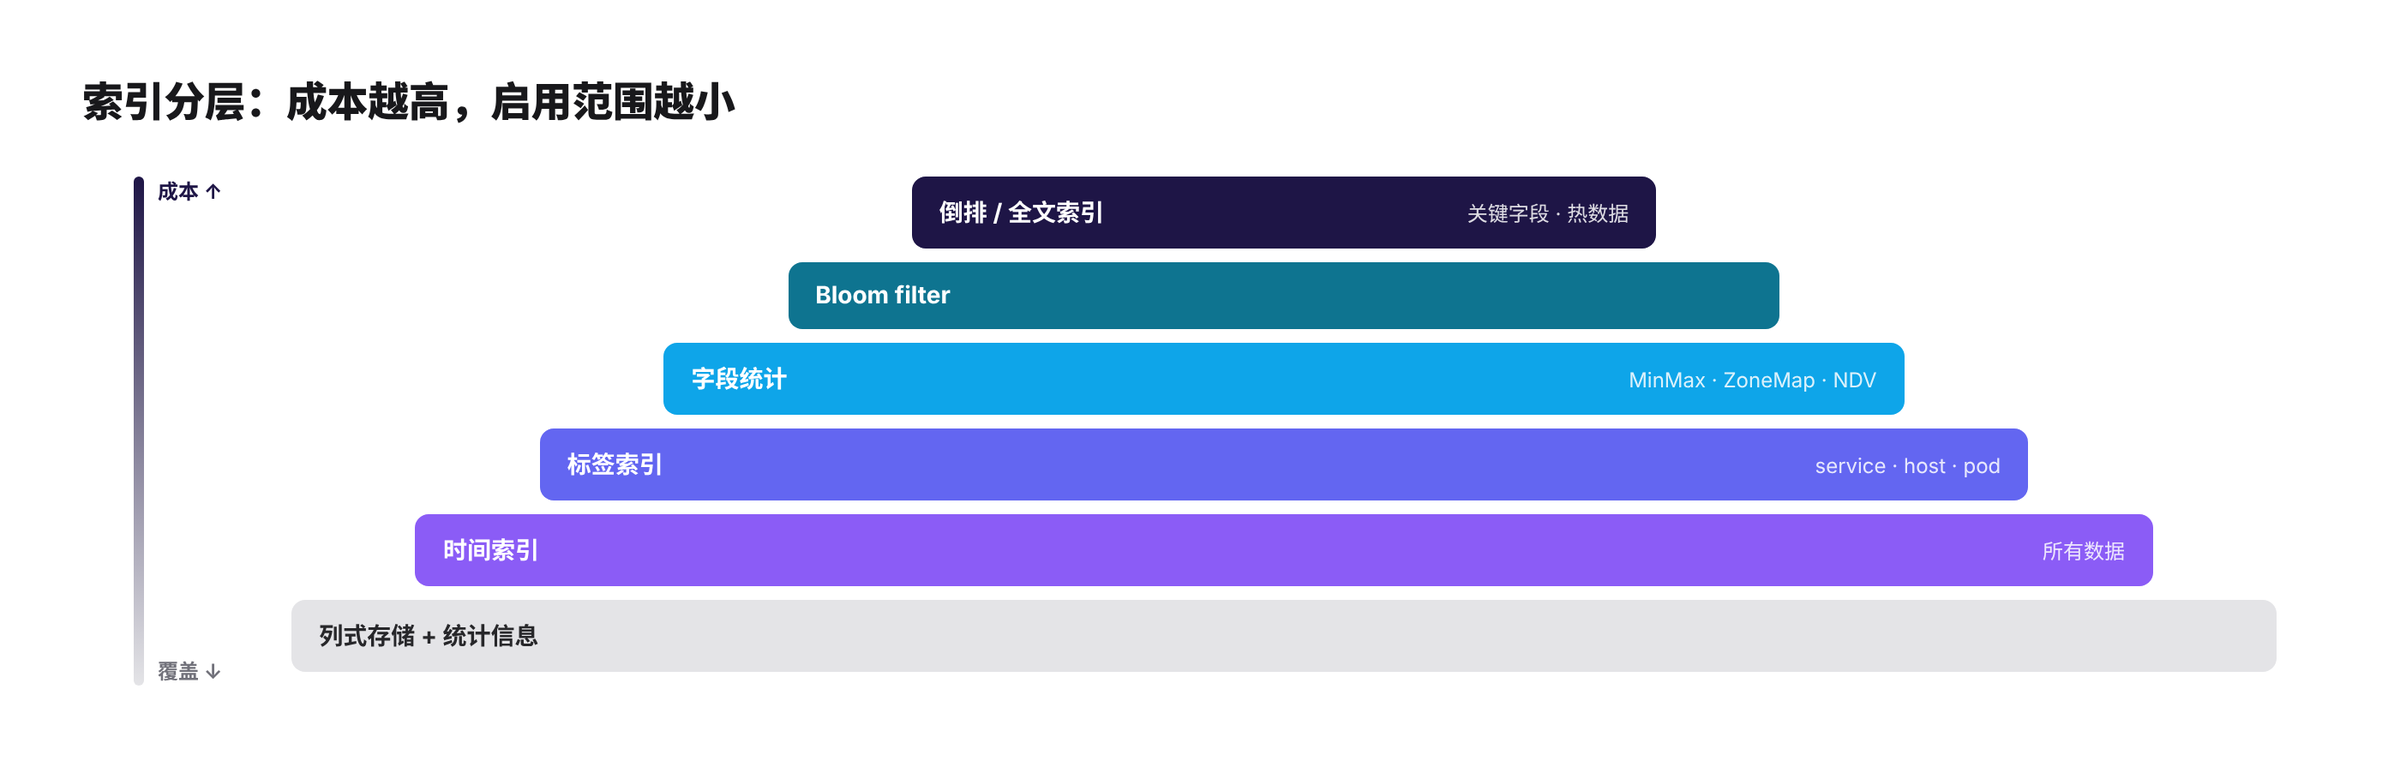
目标是在索引成本可控的前提下,让最常见、最关键的排障查询足够快。
OB Cloud 的日志表是一个具体例子:message 字段建全文索引用于关键词检索,高基数的 request_id 用跳数索引做点查,其余字段不建索引,以控制存储成本。
跨云查询要避免广播
把查询广播到所有云、扫描后再汇总,成本和延迟都会成倍放大。我们的查询链路做两级裁剪:
- 全局查询网关接收请求,按租户、时间范围、全局目录和数据驻留规则,把范围先裁剪到相关的云,未命中的云不会收到请求。
- 进入目标集群后,Frontend 规划查询,按 Metasrv 的路由信息找到对应的 Region;Datanode 再做文件、数据块和索引级别的裁剪。
- 过滤和局部聚合尽量下推到数据所在的位置执行,各云只回传命中的结果或局部聚合结果。
- 全局查询网关最后执行 merge、sort、limit 和聚合结果合并。
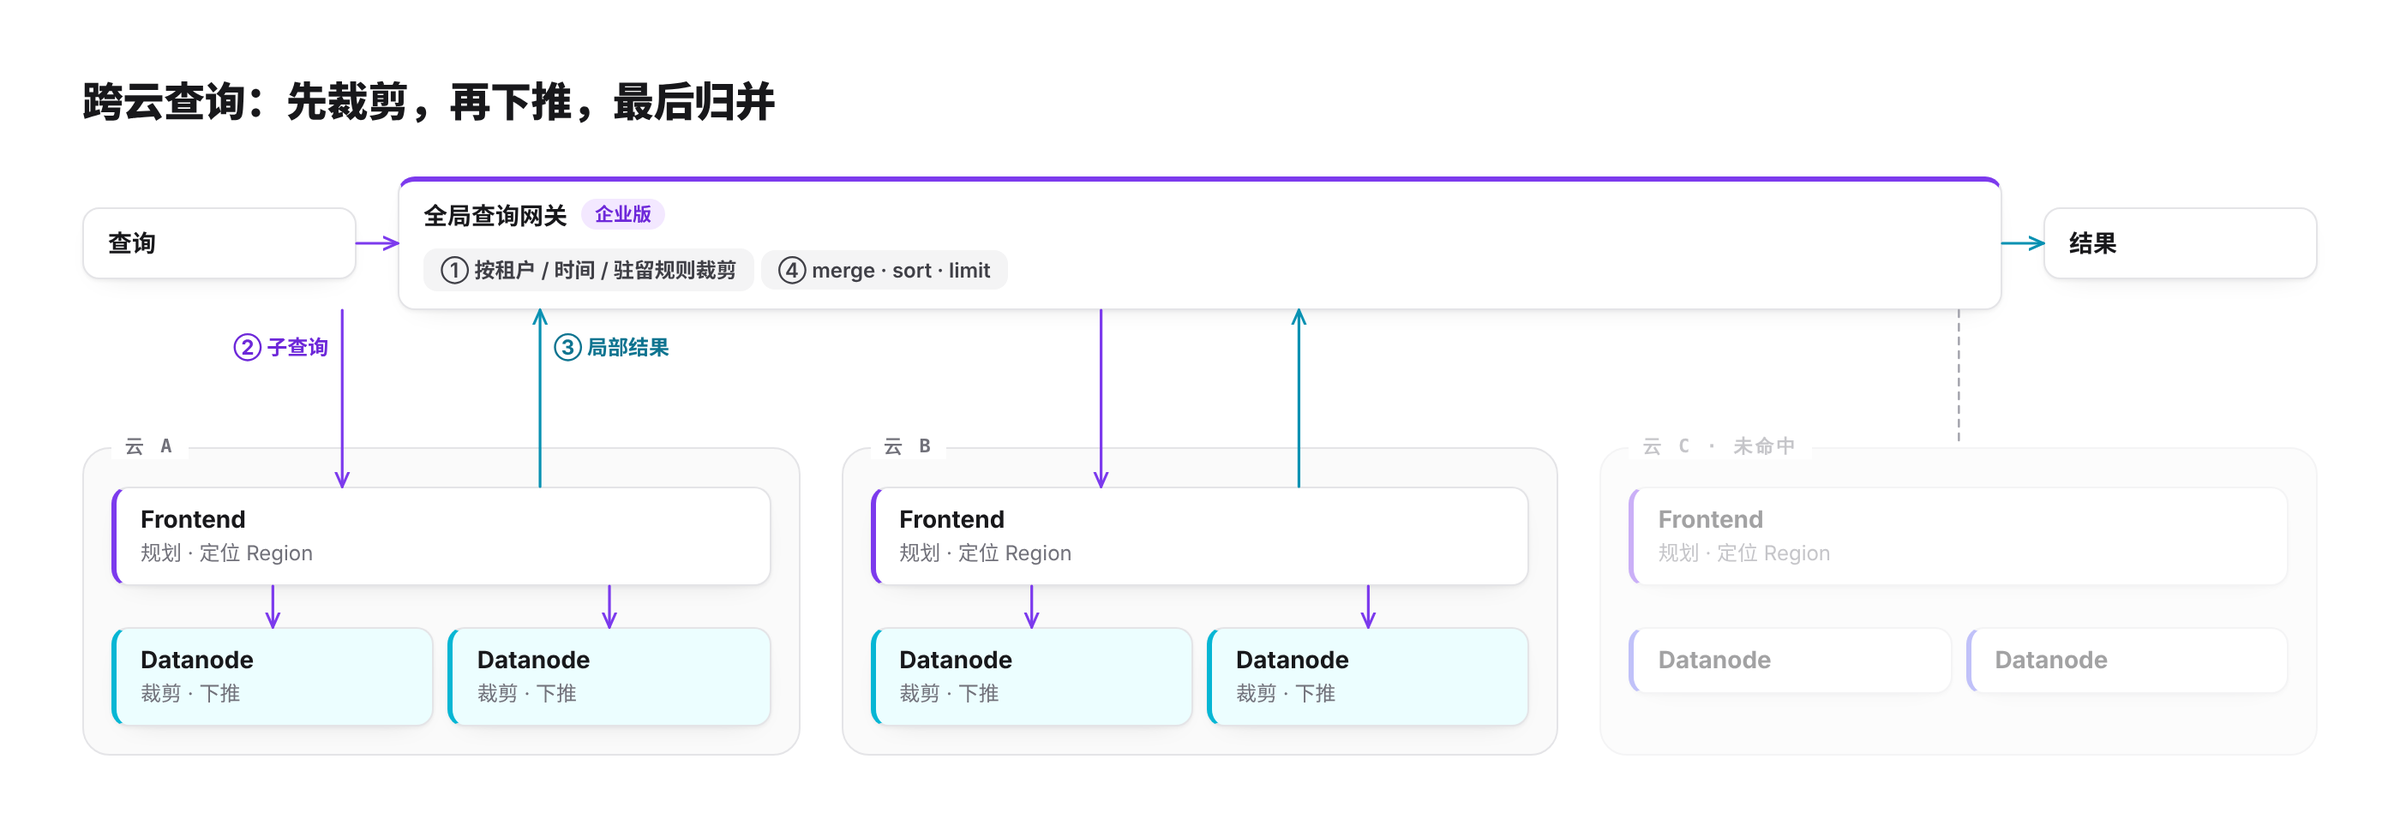
职责边界要保持清楚:跨云联邦查询由全局查询网关负责,Metasrv 只负责单个集群内部的元数据和路由。
多云系统的长期治理
多租户隔离
多租户环境至少要覆盖六类隔离:租户级数据隔离,写入配额与速率限制,查询并发与资源队列,索引预算与字段级策略,保留周期与生命周期,以及权限、审计和加密。
企业版的 Workload 抽象先把共享资源池化,再以 Workload 为单位确定计价、容量上限、流控和弹性伸缩的依据。QuotaCenter 的设计有三个要求:QuotaCenter 自身异常不影响用户请求;配额检查不阻塞请求;防止调用方把大请求拆成大量小请求来绕过配额。
分层容灾与降级
| 故障场景 | 预期降级行为 |
|---|---|
| 全局管理面异常 | 各云集群继续独立服务 |
| 全局查询网关异常 | 跨云查询不可用,各云本地入口继续服务 |
| 集群内 Metasrv 异常 | 缓存的路由仍有效时,已有 Region 可以短时继续读写;DDL、路由变更和故障转移受限 |
| 对象存储异常 | WAL 路径可以短时缓冲,无法 Flush 后进入背压;WAL-less 更直接依赖对象存储,需要更早限流 |
| 云间网络分区 | 本地集群继续服务;网络恢复后,全局目录与运行状态重新同步 |
| 系统压力过高 | 暂停低优先级 Compaction、限制冷数据大查询,优先保障热数据和关键租户 |
每一层都要明确:上游失效后,本层还能独立提供哪些能力、能维持多久、什么时候必须背压或拒绝请求。可靠性由这样一组带前提条件的降级路径构成。
成本治理
- 租户与信号配额:把写入、存储、查询和索引成本归到租户和信号类型上,分别配置预算和配额。
- 数据生命周期:按云、租户和合规区域设置不同的保留周期、采样率和冷热分层。
- 查询行为统计:按查询统计扫描量、跨云传输量和缓存命中率,再根据查询画像调整缓存、裁剪规则、索引和数据布局。
一次迁移能验证架构方向;规模继续增长后,每一项成本仍然能归因、能预测、能优化,要靠这套持续的治理。
走向 Observability 2.0
日志、指标和链路数据进入同一套列式存储和对象存储后,可以把它们看成同一种数据:带时间戳的事件。Metrics、Logs 和 Traces 是对同一组宽事件(Wide Events)的三种视图。
json
{
  "timestamp": 1689024000,
  "host": "web-01",
  "service": "payment-api",
  "cpu_usage": 85.4,
  "level": "ERROR",
  "message": "Connection timeout",
  "trace_id": "a1b2c3d4e5f6",
  "duration_ms": 1540
}
同一组事件可以按主机聚合成指标视图,可以按错误级别做日志检索,也可以按 trace_id 还原调用链:
sql
-- Metrics 视图
SELECT host, avg(cpu_usage) FROM events GROUP BY host;

-- Logs 视图
SELECT timestamp, message FROM events WHERE level = 'ERROR';

-- Traces 视图
SELECT trace_id, duration_ms FROM events WHERE service = 'payment-api';
这里的统一指事件语义统一、视图可以派生,不要求所有数据在物理上放进一张表。Flow Engine 负责持续聚合,Logs Engine 负责日志的解析、清洗和结构化。
Agent 与可观测性互相改变
一方面,Agent 读取指标、日志和事件,用大模型形成根因假设,再调用 Profile 等工具验证,最后给出修复建议。这里的要求是每一条结论都有查询和诊断证据支撑。
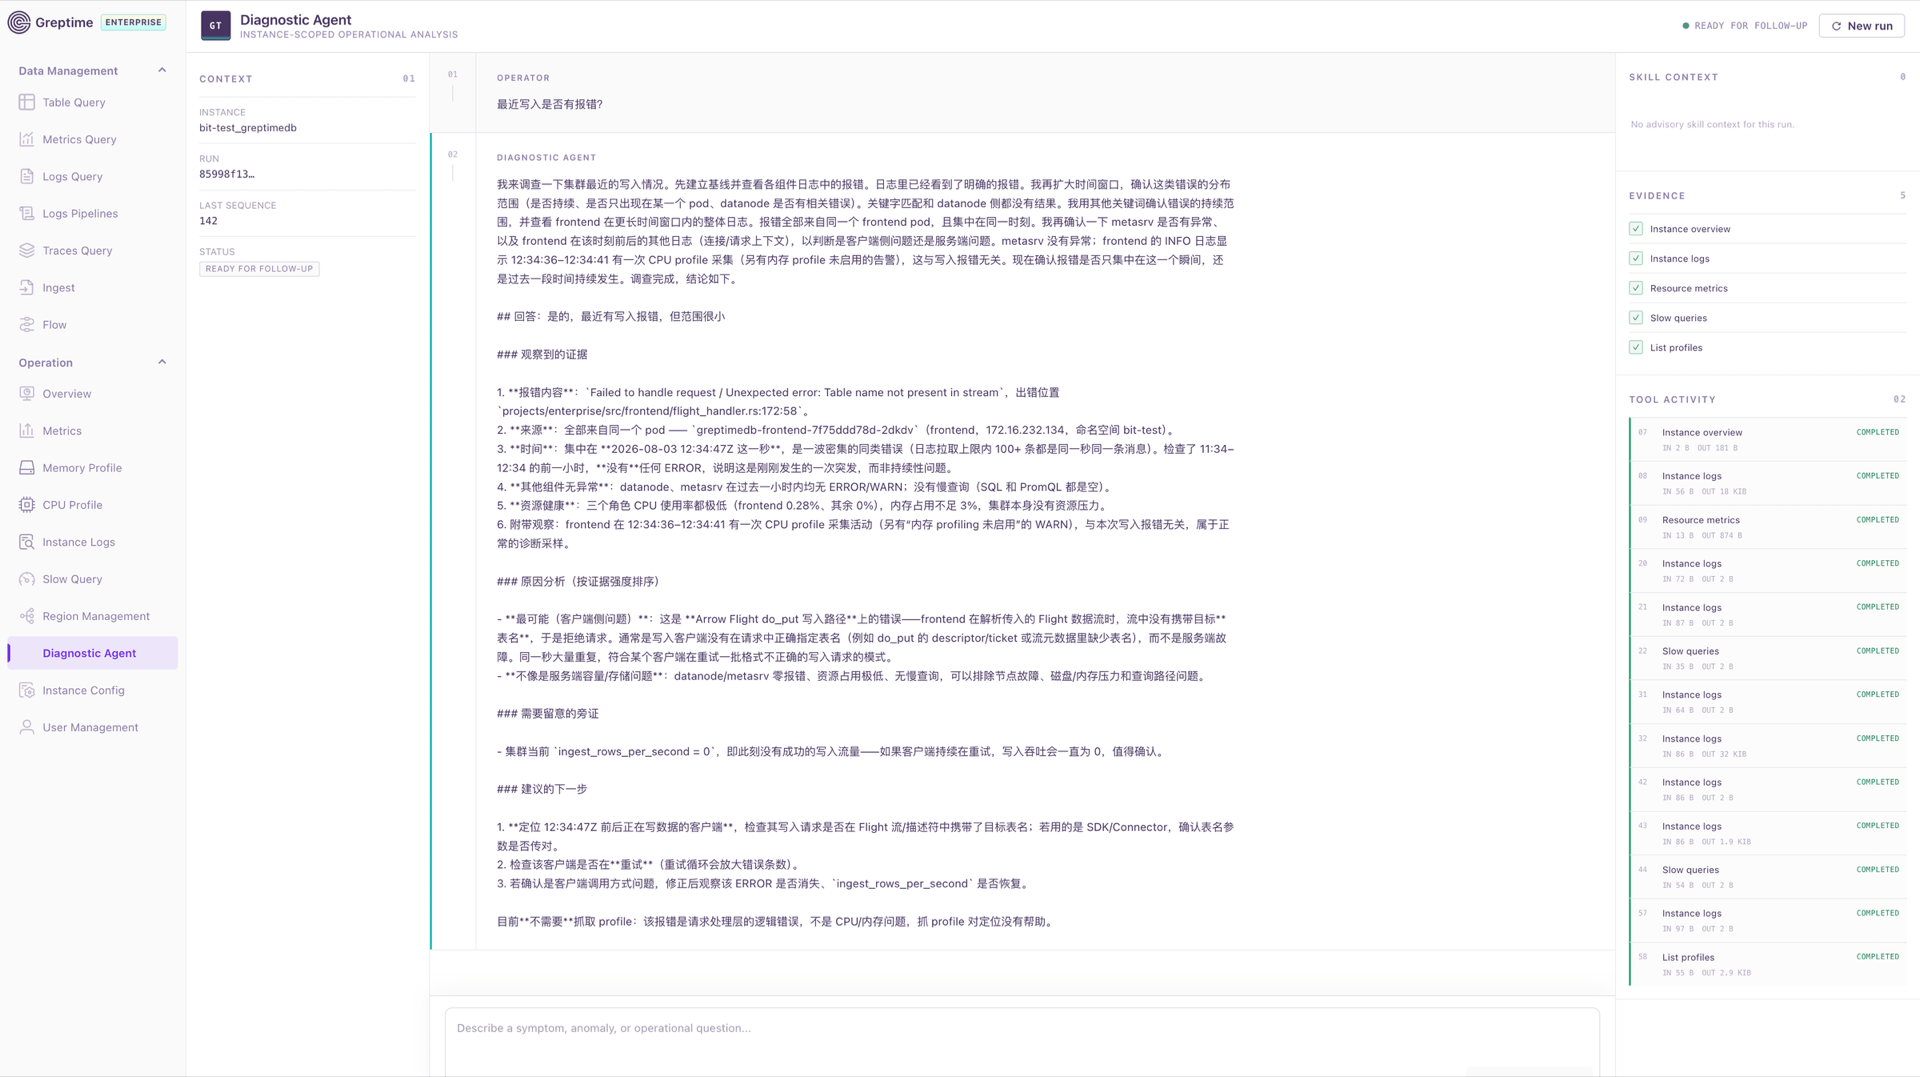
上图是 GreptimeDB 企业版 Diagnostic Agent(预览)的一次运行记录。用户问“最近写入是否有报错?”,Agent 依次查看实例概况、各组件日志、资源指标、慢查询和 profile 列表,确认报错只来自一个 Frontend Pod、集中在一秒内、其他组件无异常,判断为客户端写入请求缺少表名,并说明这次不需要抓取 profile。
另一方面,可观测性系统也要给 Agent 提供机器可读的语义。Table Semantic Layer(实验特性)保存 signal type、source、metric type、unit、temporality 等信息,MCP Server 和 Agent 读取这些信息,不用再猜表名、字段、单位和聚合方式。
访问模式也在变化。人排障通常沿一条假设往深处查;Agent 更容易同时保留多个候选解释,并行查询多个信号、实例和时间窗口,再根据证据排除。这给数据库带来更高的 fan-out 和更密集的小查询,对查询预算、取消、并发调度、缓存、裁剪和跨信号关联都提出了新的要求。
结语
多云环境下的可观测性数据库,我们的设计是:管理和访问入口统一在全局层,数据和计算留在每朵云的集群里;对象存储负责降低长期成本,写入、缓存和查询调度层负责处理对象存储的延迟、计费和接口限制;索引按预算分层;跨云查询先裁剪再下推;每一层在上游故障时都有明确的降级行为。OB Cloud 从日志起步,正在把 SkyWalking 的链路和 APM 数据也迁到同一套数据底座上,供 SRE Agent 使用;这套底座也在为并发更高、更依赖语义的 Agent 查询做准备。
参考资料
- OB Cloud 用户案例:从 Loki 到 GreptimeDB
- GreptimeDB 文档
- GreptimeDB Table Semantic Layer(实验特性)
- USENIX:Responding to and Learning from Distributed Incidents
本文整理自技术分享《多云原生可观测性数据库系统设计》。请添加微信号 greptime 获取演讲 PPT。


