本页内容

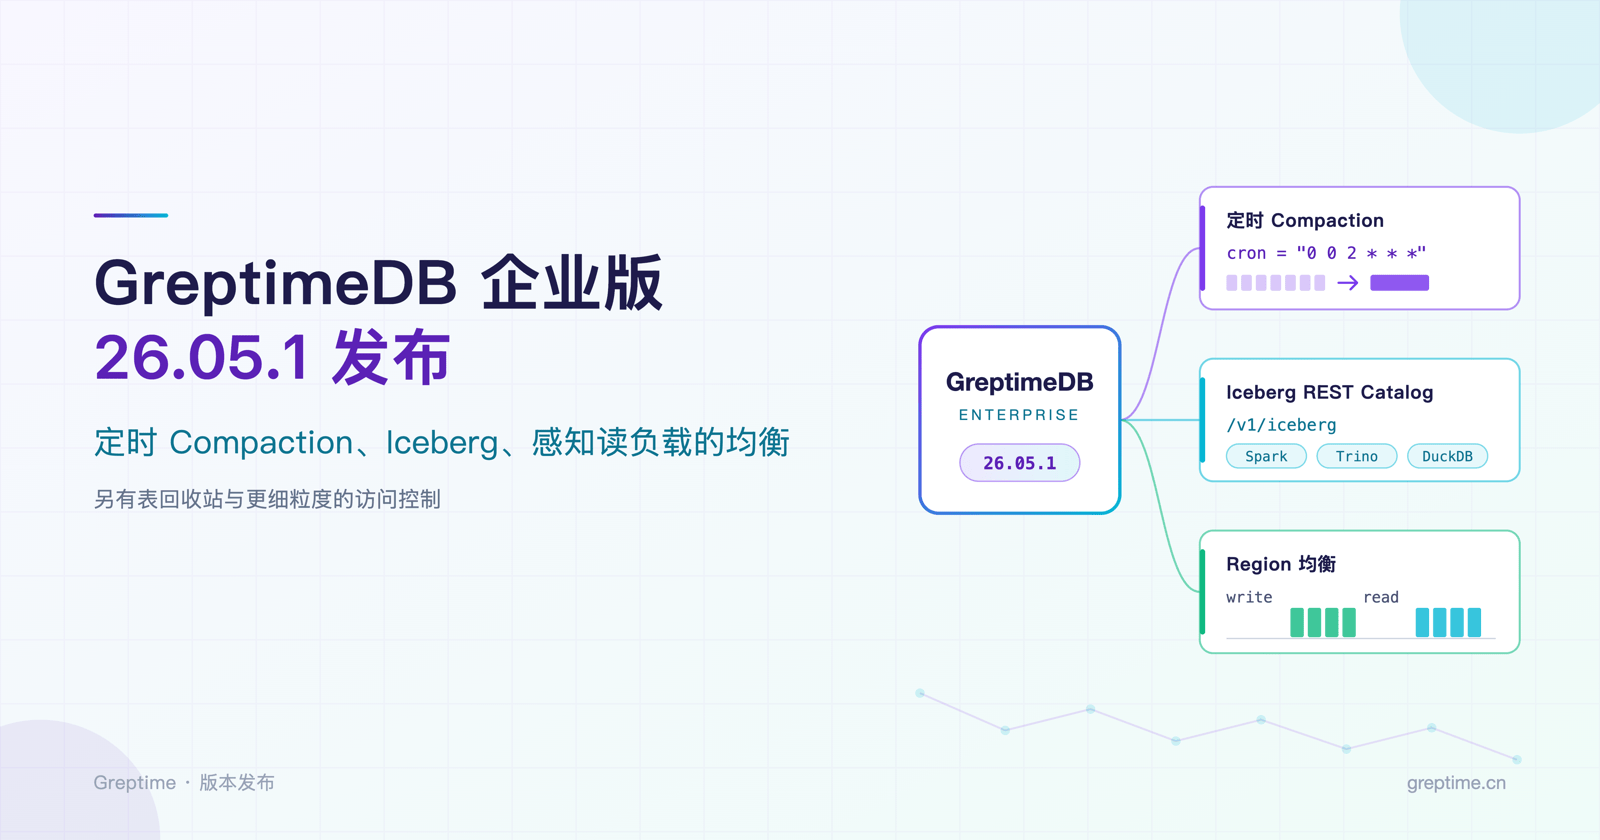
GreptimeDB 企业版 26.05.1 是 26.05 系列的小版本更新,包含多项企业用户需求集中的运维能力:定时执行的 Compaction、通过 Apache Iceberg 供数据平台直接读取 GreptimeDB 的表,以及同时考虑读写负载的 Region 均衡。引擎基座同步升级到开源 GreptimeDB v1.2。此外,本版本新增可选的表回收站,并细化了访问控制。
定时 Compaction
Compaction 直接影响查询性能和存储占用。此前,Compaction 的执行时机由 GreptimeDB 自动判断,或由运维人员手动触发。这种方式适用于负载平稳的场景,但在大规模部署中存在不足:高吞吐写入,尤其是企业版独有的批量写入(bulk ingestion)路径,会在短时间内产生大量小 SST 文件;如果不能及时执行 Compaction,存储会膨胀,扫描也会变慢。定期 Compaction 将这些小文件重写为更合理的数据布局,带来两方面收益:需要扫描的文件数量更少、单个文件更大,查询更快;数据排布更紧凑,压缩率更高,存储成本更低。
26.05.1 新增 Compaction 定时任务(cronjob)。它是由 Metasrv 管理的调度器,负责跨 Region 确定 Compaction 目标、提交并跟踪任务、将任务状态持久化到 KV 存储,并自动取消已失效的运行中任务。
例如,以下配置使 Compaction 在每天凌晨 2 点的业务低峰时段执行:
toml
# metasrv 配置
[[plugins]]
compaction_cronjob = { enable = true, cron = "0 0 2 * * *" }
默认调度为每天午夜执行一次。可调整的参数包括:单个任务中并发执行 Compaction 的 Region 数量、单次请求的 Compaction 并行度,以及保留的任务历史记录条数。
定时 Compaction 与 v1.2 引擎引入的按时间范围手动 Compaction 相互补充:日常维护由定时任务完成,需要时再针对特定的热点时间窗口手动执行 Compaction。
Apache Iceberg 支持(早期预览)
时序和可观测性数据通常存储在 GreptimeDB 中,而数据平台使用 Spark、Trino、DuckDB、pyiceberg 等兼容 Iceberg 的引擎,两者彼此独立。常见的做法是通过 ETL 或双写管道将数据复制一份,这会增加存储和成本,多份数据之间也容易出现不一致。关于这一问题的背景,参见《Observability Data Lake:不仅仅是数据湖》。
26.05.1 提供 Apache Iceberg 数据湖支持的早期预览,实现方式是元数据双写(metadata dual write)。GreptimeDB 的 SST 数据文件本身以 Parquet 格式存放在对象存储中。每次写出 SST 文件(flush 或 Compaction)时,GreptimeDB 会同时写入指向这些文件的 Iceberg 元数据,包括 manifest、manifest-list 和表快照;Frontend 在 /v1/iceberg 上提供 Iceberg REST catalog。整个过程只复制元数据,数据只保存一份,兼容 Iceberg 的引擎可以直接从对象存储读取这些表:
- 不复制数据文件。 元数据双写附加在 GreptimeDB 现有的写入路径上,不增加数据存储成本,也不需要维护第二条数据同步管道。额外产生的只有 Iceberg 元数据,其体积比数据本身小几个数量级。
- flush 后可见。 每次 flush 和 Compaction 都会发布新的 Iceberg 快照。如需让刚写入的行立即可见,对该表执行 flush,这些行随后会出现在新快照中。
- 覆盖表的完整生命周期。 本版本将导出扩展到表生命周期的各个环节:
ALTER TABLE的 schema 变更会同步到 Iceberg;repartition、truncate 和 drop 之后,导出状态保持一致;批量写入和远程 Compaction 通过同一管道发布元数据;Prometheus native histogram 和 metric 引擎的物理表也支持导出。
启用时,需要在写入进程(Datanode 或 Standalone)和 Frontend 上分别添加插件配置,两者的 warehouse_root 必须一致:
toml
# Datanode(或 Standalone)和 Frontend 均需配置,warehouse_root 保持一致
[[plugins]]
iceberg_manifest = { warehouse_root = "iceberg_warehouse" }
随后在 GreptimeDB 的 SQL 控制台中正常写入数据,并执行 flush 以发布刚写入的行:
sql
CREATE TABLE demo (
    ts TIMESTAMP(6) TIME INDEX,
    host STRING,
    cpu  DOUBLE
);

INSERT INTO demo VALUES
    ('2026-09-16 00:00:00', 'h1', 12.5),
    ('2026-09-16 00:05:00', 'h1', 88.8),
    ('2026-09-16 00:05:00', 'h2', 55.0);

-- 为刚写入的行发布 Iceberg 元数据
admin flush_table('demo');
在 Iceberg 一侧,这张表与普通 Iceberg 表没有区别。将查询引擎指向 REST catalog 即可查询,例如使用 pyiceberg:
python
from pyiceberg.catalog.rest import RestCatalog

catalog = RestCatalog(
    name="greptime",
    uri="http://<frontend>:4000/v1/iceberg",
    prefix="greptime",
    # 加上对象存储凭据,引擎即可读取 Parquet 数据文件
)

table = catalog.load_table(("public", "demo"))
print(table.scan().to_arrow().to_pandas().head())
或使用 Spark SQL,将 spark.sql.catalog.greptime.uri 设置为同一端点:
sql
SELECT host, round(avg(cpu), 1) AS avg_cpu
FROM greptime.public.demo
WHERE ts >= '2026-09-16 00:00:00'
GROUP BY host;
时间范围过滤、聚合、join 和窗口函数的用法与其他 Iceberg 表相同。如果计划通过 Iceberg 从 Spark 查询某张表,建议将时间索引列声明为 TIMESTAMP(6),如上例所示。这样,磁盘上 Parquet 文件的时间精度与 Iceberg schema 一致,基于文件统计信息的裁剪在 > 和范围谓词上才能正确生效。已有的表可以通过 ALTER TABLE demo MODIFY COLUMN ts TIMESTAMP_US 原地无损提升时间精度。同一个 catalog 也可供 Trino、DuckDB 等兼容 Iceberg 的客户端使用,完整的客户端配置见 Iceberg 导出文档。
作为早期预览,该功能目前有以下限制:导出为只读,GreptimeDB 是唯一的写入方;仅暴露最新快照,不支持 time travel;少数 GreptimeDB 类型映射到 Iceberg 时有损。完整的类型映射和限制说明见 Iceberg 导出文档。
多维度的 Region 均衡
Autopilot 中的 Region Balancer 负责在各 Datanode 之间均衡写负载。但写入均衡的集群,查询负载仍可能失衡:仪表盘、查询量大的 Grafana 面板和分析查询,会集中消耗持有热点 Region 的 Datanode 的 CPU,而仅基于写负载的均衡器无法感知这类失衡。
26.05.1 将 Region 均衡扩展为多维度:除写吞吐外,均衡器还会记录每个 Region 的查询 CPU 使用率历史;每个维度采用独立的稳定性规则,读负载需要在比写负载更多的统计窗口内持续偏高才会触发迁移,以过滤短时毛刺;各维度的均衡状态分别维护。在读写混合负载下,Region 分布更加稳定;节点重新加入、Region 重新分布等计划内维护期间的意外情况也会减少。
配置方面,读维度有独立的稳定性阈值,且默认比写维度更严格,仅凭一次仪表盘查询突增不会触发 Region 迁移:
toml
[[plugins.autopilot]]
tick_interval = "45s"

[[plugins.cluster_stat]]
sampling_window = "45s"
max_history_windows = 5

[[plugins.region_balancer]]
acceptable_load_ratio = 0.12
min_load_threshold = "4MB"
region_migration_cooldown_period = "1h"
write_window_stability_threshold = 2
read_window_stability_threshold = 4
调参方式与此前一致:为每个维度设定「高负载」的判定阈值,通过冷却时间避免同一 Region 被反复迁移,并限制每个调度周期内的迁移次数。已在使用 Region Balancer 的集群,升级后读维度自动生效,无需单独开启。各参数的说明见 Region Balancer 文档。
可选的表回收站
此前,DROP TABLE 立即生效且无法恢复。26.05.1 支持配置 soft drop:启用后,DROP TABLE 不再直接销毁表,而是关闭其 Region,并将元数据移入 tombstone。该表不再出现在常规 DDL 和 DML 中,但数据仍然保留,可以恢复。
toml
[gc]
enable = true

[gc.experimental_soft_drop]
enable = true
retention = "7d"
被删除的表进入回收站,可通过以下语句查询:
sql
SELECT original_object_name, dropped_at, retention_expires_at
FROM information_schema.recycle_bin;
恢复表只需一条语句;提前清除或等待保留期到期后,存储空间即被释放:
sql
-- 连同原始数据一起恢复表
UNDROP TABLE monitor;

-- 或在保留期到期前永久销毁
ADMIN purge_table('monitor');
回收站中的表仍占用存储空间,保留期决定了可恢复时间与存储成本之间的取舍。名称冲突规则和清除语义见 soft-drop 文档。
更细粒度的访问控制
- 命名权限动作(named permission actions)。 Iceberg 读取、Pipeline 管理、Dashboard 操作等企业版能力现在都是独立的命名动作,可以授予自定义角色。例如,「数据平台」角色可以只授予
iceberg.read;Grafana 服务账号可以只授予 Grafana 所需的权限。 - 基于正则表达式的数据库 ACL。 数据库访问规则支持正则表达式。一条
~regex:tenant_[0-9]+规则即可覆盖所有带租户前缀的数据库,无需逐个列举;规则创建之后新建的数据库同样适用。 - 创建者自动授权。 创建数据库的用户自动获得该数据库的完整访问权限,避免创建者无法访问自己所建数据库的情况。
- 防止误操作的 query guard。 可选的 Frontend 级防护,可禁止所有用户(包括管理员)执行
DROP TABLE和DROP DATABASE,也可按需加入TRUNCATE TABLE、DELETE和ALTER TABLE ... DROP COLUMN。query guard 不区分用户权限,一律拦截,是生产环境中防止误执行 SQL 的最后一道防线:
toml
[[plugins]]
query_guard = { enable = true, banned_ops = ["drop_table", "drop_database"] }
基于 v1.2 引擎
引擎基座已升级到开源 GreptimeDB v1.2,完整内容见 v1.2.0 发布文章。制定升级计划时,建议先阅读其中的兼容性说明。对企业部署影响较大的更新包括:
- JSON2 类型:支持 SQL 路径访问,为日志和 Agent 事件提供结构化、可裁剪的存储。
- 生命周期事件记录:数据库/表/视图 DDL、Flow DDL、repartition、GC 和 WAL prune 都会生成结构化的过程事件,可在 Enterprise Dashboard 中查看,便于审计集群执行了哪些操作及其执行时间。
- 性能:series key 采用字典编码,引入该优化的 PR 中的测试显示端到端性能提升约 24%;RangeSelect 更早裁剪输入列;compaction picker 改为异步执行,不再阻塞 Region worker。
可靠性与安全
本版本的主要问题修复:批量写入在写入前校验 JSONB 列的数据类型;PromQL 的 or 在操作数为空时不再返回错误结果;MySQL 协议遇到无法表示的时间戳时直接报错,不再静默地错误处理;Prometheus remote-write 超时可以重试;修复了异步索引构建与 schema 变更之间的竞态问题。升级后旧版 WAL 配置仍然兼容,现有配置无需修改。
安全方面,HTTP API 可以通过独立端口提供服务(需手动开启);SQL 中的本地文件访问(COPY、外部表)被限制在沙箱目录内,无法越界读取本地文件系统。
获取 26.05.1
完整变更见发布说明。Iceberg 预览、定时 Compaction、多维度 Region 均衡和 soft drop 的详细说明,见 Iceberg、Region Balancer 和 soft-drop 文档。如需讨论具体部署方案,请联系我们。


