本页内容

在格拉斯哥举办的 Apache Community Over Code EU 2026 上,OpenAI 数据平台的工程师做了两场关于大规模运行 Apache Spark 的演讲:《Operating Apache Spark at OpenAI's Hyperscale Lakehouse》和《Beyond the Spark UI: Building Agent-Native Observability at OpenAI》(下文分别简称「湖仓演讲」和「Agent 演讲」)。两场演讲的录像都已公开,也都讲到了 GreptimeDB 如何进入他们的 Spark 可观测性体系。
本文是我们对这两场演讲的解读。文中关于 OpenAI 系统的内容都来自演讲者在台上的讲述,并标注了视频时间点,方便对照原视频核对。我们自己的观点会单独说明。
规模
湖仓演讲先给出了 OpenAI 的湖仓规模(15:27)。OpenAI 在 Azure 和 AWS 两朵云上运行 Spark,数据规模达到多个 EB。每天运行几十万个 Spark 应用,对应每天几千万个 Kubernetes pod。S3 和 Azure Blob Storage 的平均读取吞吐是每秒数 TB,Celeborn shuffle 服务在所有负载上的吞吐达到每秒百 TB 量级。
演讲者把挑战归为四类(17:38):Kubernetes 控制面、云厂商配额与 S3 限流、可观测性,以及运维负担。本文只讨论其中的可观测性部分,其他部分建议直接观看视频。
每个慢作业背后的三个问题
Agent 演讲把 Spark 可观测性归结为三个问题(0:16):是哪一次运行、时间花在了哪里、发生了什么变化。
在 OpenAI 的规模下,回答这三个问题很慢。一些应用的事件日志经常超过 100 GB,在 Spark History Server 里打开其中一个,首页渲染出来可能要半小时(1:15)。开始用 Agent 回答 Spark 问题之后,Agent 的每一次工具调用也要等同样的加载(1:35)。
他们的系统经过了四步演进。
第一步:让事件日志可以查询
作业结束时,OpenAI 的 gateway 服务发布一条 Kafka 事件。一个 Flink 作业消费这条事件,从 S3 读取事件日志并解析,按实体写入各自的 Kafka topic,再由已有的基础设施导入 Delta 表(3:14)。主键取自 Spark 自身的 app status store,因此 job、task、executor 和 SQL execution 的 ID 都与 Spark UI 一致(4:58)。
这些表可以回答跨应用的问题,例如昨天哪些 stage 溢写最多,上周最常见的五个失败原因是什么(5:28)。此时 History Server 本身还没有变化。
第二步:让 History Server 变快
慢在重放。History Server 要解压并重新解析每一行事件日志,重建出 driver 运行期间 live UI 已经持有的那份 KV store(5:46)。
于是 driver 在应用结束时把这份状态以 snapshot 的形式写到 S3,最后写入的 manifest 作为提交点(8:23)。History Server 直接恢复 snapshot,只有 snapshot 缺失或无效时才回退到重放事件日志。在生产环境的 Spark 3.5 上,P90 加载时间提升约 10 倍,P99 提升约 30 倍(9:25)。
之后他们用 Rust 重写了 History Server,基于 prost、tokio 和 axum。在 snapshot 的基础上,首次加载又快了约 3 倍,页面切换快了约 2 倍(10:15)。snapshot 的工作以 SPARK-56093 提交到了上游。演讲时原 PR 已经停滞,OpenAI 自己也已不再使用 snapshot,演讲者当时欢迎其他人接手(21:21);10 月 22 日,作者重新提交了 #59696,目前仍在评审中。
第三步:让 Agent 使用同一份证据
Agent 演讲的后半部分讲的是现在由谁来读这些数据。Agent 已经成为 Spark 排查的常规第一步,调试和调优都是(18:08)。
只有原始工具还不够。仅靠 MCP server 和 CLI,Agent 容易过度取数,得出的结论也不可靠,所以团队编写了边界清晰的 skill(13:15)。skill 会先确认用户要排查的是失败还是性能问题,再开始消耗 token(14:52)。它在底层检查的就是人会检查的那些项目:数据倾斜、分区数、溢写、shuffle、GC 以及 UDF 的使用(15:58)。由于 Spark 作业都在一个 monorepo 里,Codex 还能从作业 ID 追溯到提交它的 Airflow DAG 和代码(13:35)。
第四步:GreptimeDB
这场演讲的内容写于 2 月前后。投稿约三个月后,团队就切换到了 GreptimeDB,原因是**「we found that it was more effective」**(19:02、29:44)。
现在,Spark driver 里有一个自定义的 GreptimeDB listener,把结构化记录发送给集群本地的 Grafana Alloy,记录涵盖 application、job、stage、task、executor 和 SQL 执行计划。Alloy 负责攒批和重试,再写入 GreptimeDB(19:14)。History Server 也改为从 GreptimeDB 读取,不再读 S3 上的 snapshot(20:23)。介绍这一步的幻灯片把它称为「live, selectively queryable Spark state」。
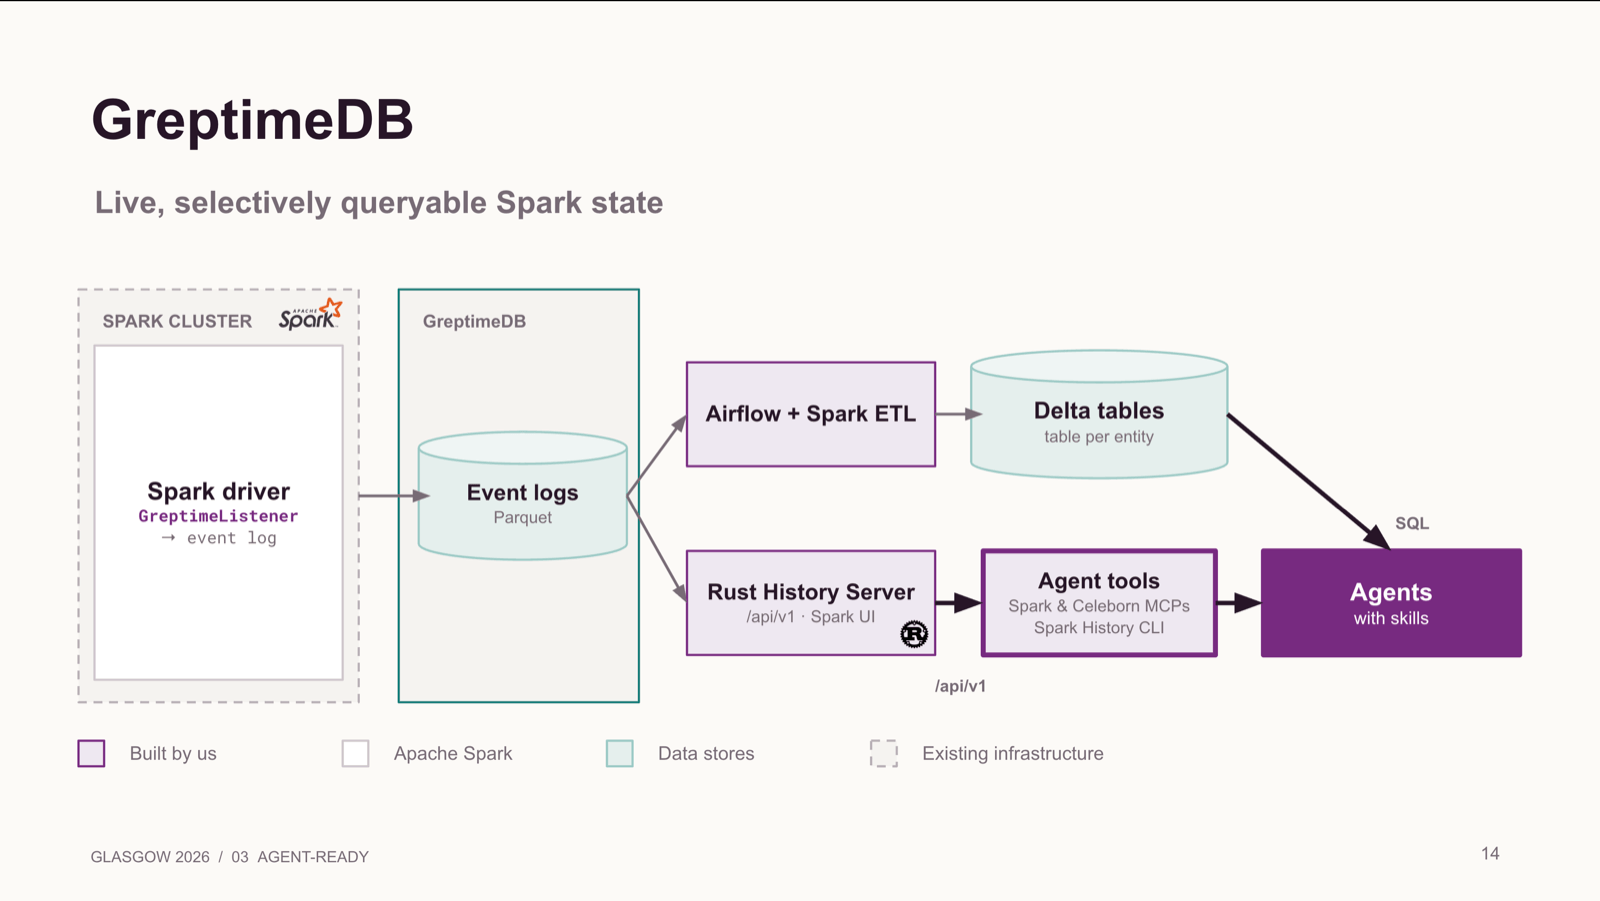
演讲者给出的理由是(19:51):GreptimeDB 把事件日志和指标整合到同一个系统里,而且数据底层是 Parquet,原始数据本身就能直接用 Spark 查询。他们仍然会把数据从 GreptimeDB ETL 成反规范化的 Delta 表。
这一步还去掉了一条数据管道。原来负责解析事件日志的 Flink 作业,按演讲者的说法「probably one of the most expensive Flink apps at OpenAI」,处理数据倾斜也特别困难。换成新链路之后,他们「don't really need Flink anymore」(20:28)。
在问答环节,演讲者补充了两个细节。GreptimeDB 里的数据保留约两周,用于查询和调试,足够对比每周运行一次的作业;Delta 里的聚合统计保留 90 天(23:35)。他们也特意没有把这套方案推荐给所有人:直接换到 GreptimeDB「may not be a good fit for everyone」,有些团队可能更想从更容易上手的方案开始(28:02)。
基础设施视角下的同一个选择
湖仓演讲从另一个方向走到了 GreptimeDB。
演讲者希望记录每一个 Spark task 的指标:读了多少数据、写了多少数据、耗时多久(19:43)。每个 task 一条时间序列,每天就会新增数百万到数千万条序列,一年下来是数十亿条。按演讲者的说法,他们已经在用的系统都无法承受这样的基数(21:02)。
第二个问题是信号分散。日志、指标和事件存放在不同的存储系统里,出现事故或排查性能问题时,没有好的办法把它们关联起来(29:58)。
为了同时解决这两个问题,他们选择了 GreptimeDB(30:44)。GreptimeDB 存储 Spark 的指标、事件和日志;CPU 和内存的 profiling 数据交给 Pyroscope,演讲者提到这是 GreptimeDB 目前唯一不支持的信号(31:00)。profile 的支持见 #6760。数据由 Grafana Alloy 采集,Grafana 和 Rust 版 Spark History Server 从 GreptimeDB 读取。由于 GreptimeDB 以 Parquet 格式把数据存在 S3 上,团队可以把数据导出,或映射为 Parquet、Iceberg、Delta Lake 表,再用 Spark 和 Trino 分析(31:51)。
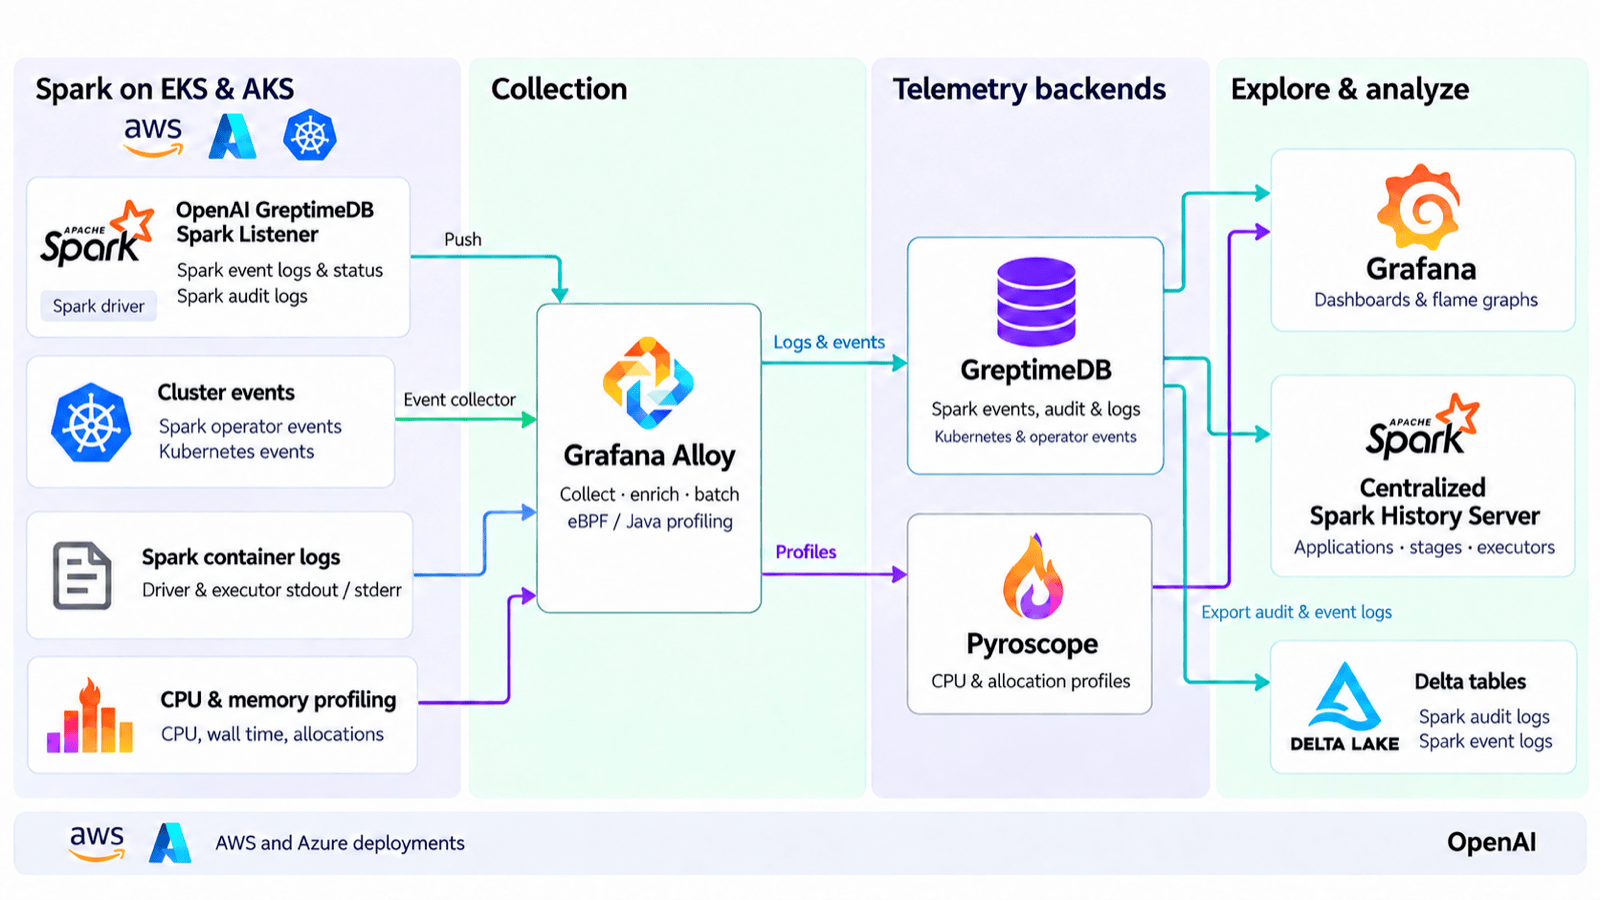
从架构图看,写入 GreptimeDB 的除了 Spark 的事件和日志,还有 Spark 审计日志,以及 Spark operator 和 Kubernetes 的集群事件;审计日志和事件日志再导出到 Delta 表。
演讲最后讲到运维。除了一组 Kubernetes operator,团队还运行着一个名为 Yoda 的内部 Agent。它从 GreptimeDB 和其他系统获取数据,在 Slack 里回答用户关于作业变慢或失败的问题,并在告警触发时协助做根因分析(33:39)。
我们的看法
以下是 Greptime 的观点,不代表 OpenAI。
高基数和信号分散是一起出现的。 湖仓演讲把它们列为两个问题,但根源是同一个:一旦可观测性数据细到有用的程度(按 task 而不是按 job),序列数量就会超出把索引放在内存里的存储系统的承受范围,演讲者对传统可观测性系统的描述正是如此(19:47);再按信号类型分开存放,排查所需的关联就更难做。能同时处理这两点的存储,解决的其实是一个问题。
每一步都少了一份拷贝。 重放是在重建 driver 已经有的状态;snapshot 把这份状态保存一次;把实时记录直接写入可查询的存储,又去掉了 Flink 那条负责解析和导入的数据管道。四步演进的方向,是让数据只落在一个地方(single source of truth),并减少搬运它的数据管道。
Agent 让「拿到证据的延迟」变成了硬性要求。 人可以偶尔为一个 History Server 页面等半小时,一个要做几十次工具调用的 Agent 不行。团队的应对不只是更快的存储,还有决定该取什么数据的 skill。两者缺一不可,后者不是数据库能解决的,靠的是团队把排查经验沉淀成 skill。
开放格式让可观测性数据和 lakehouse 共享同一份数据。 GreptimeDB 写出的 Parquet 文件,和 OpenAI lakehouse 其他部分读取的是同一种格式。Spark 和 Trino 可以直接查询原始的可观测性数据,反规范化的 Delta 表现在也直接由 GreptimeDB 的数据生成,不再依赖单独负责解析的数据管道。
关于数据库这一侧,我们在《Observability Database:数据库该理解遥测数据吗?》里做过更完整的讨论。这两场演讲从一个大规模生产团队的角度,独立描述了同样的问题。
感谢两场演讲的演讲者与社区分享他们的工作。如果本文有与演讲内容不符之处,欢迎联系我们更正。


