本页内容

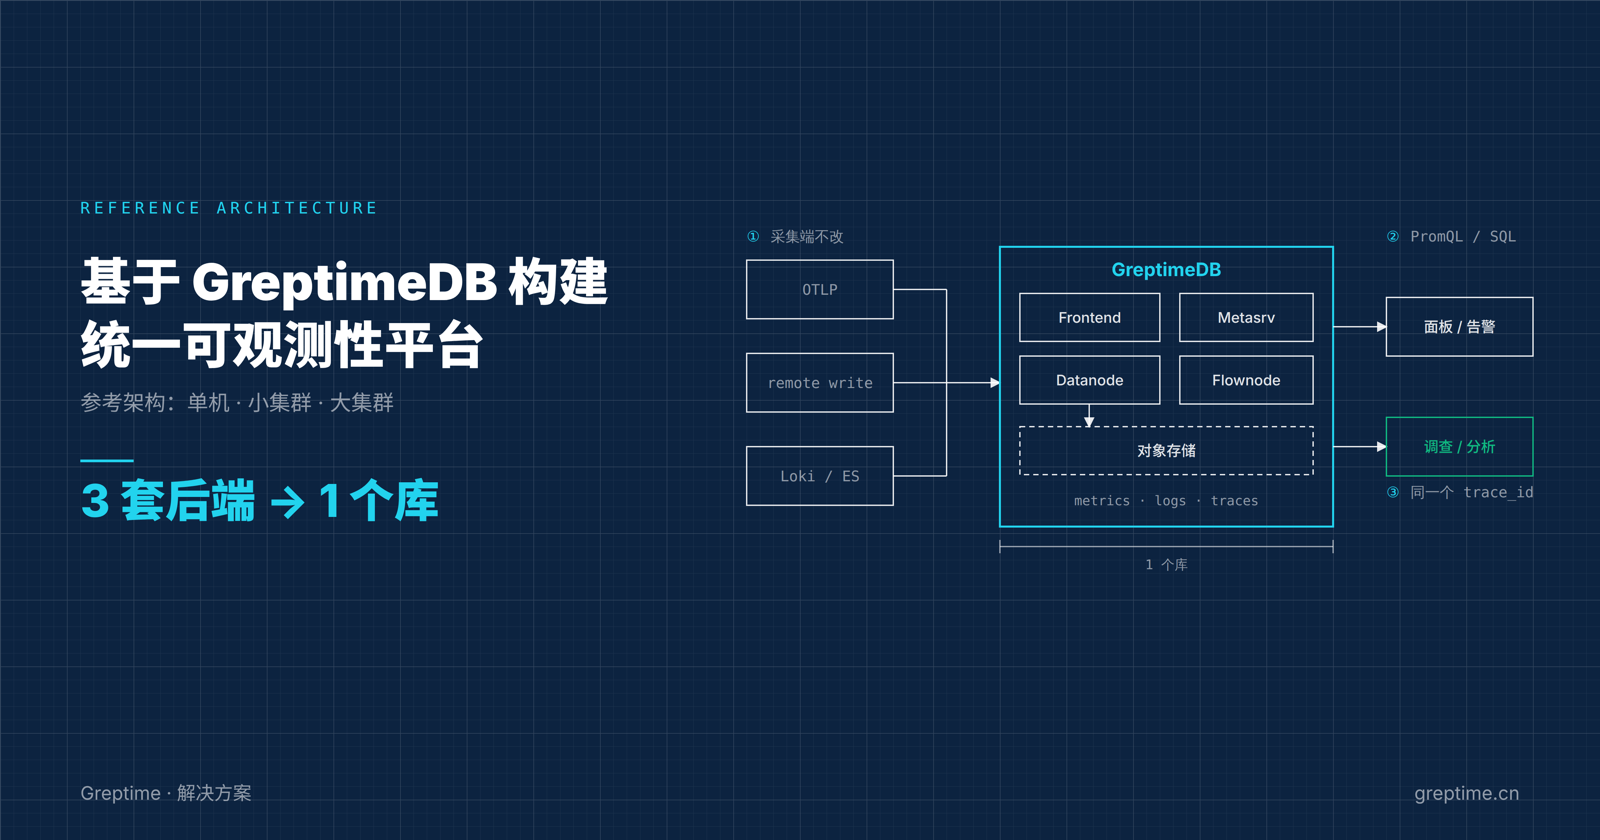
这篇文章假设你已经决定把 metrics、logs、traces 收进一个数据库。为什么要统一、为什么是现在,我们在可观测性统一历史的文章里已经写过。这篇回答决定之后的问题:要部署哪些组件,数据怎么流,需要做哪些决定,以及单机、小集群、大集群三种规模下的拓扑。架构本身可以用一句话概括:采集端不动,写入地址改成同一个 GreptimeDB;面板和告警走 PromQL,事故调查和长周期分析走 SQL。
验证环境用的是 OpenTelemetry 官方的 Astronomy Shop demo:14 个服务,多种语言的 SDK,默认后端是 Jaeger、OpenSearch 和 Prometheus 三套。我们把三套换成一个 GreptimeDB v1.2.0 单机,加一个 node_exporter 和一个只做抓取的 Prometheus。文中的配置、表结构、查询结果和故障记录取自这个环境,完整配置在 greptimedb-observability-playground 仓库。涉及企业版的能力会单独标出。
这套平台要承担的三类负载
面板与告警。Grafana 面板每几秒刷新一次,告警规则每分钟评估一次,查询的是最近几分钟到几小时的数据,查询数量大、单个查询小、对延迟较为敏感。
故障调查。一次调查在 metrics、logs、traces 之间切换:从告警找到慢的服务,从服务找到慢的调用链,从调用链找到那段时间的错误日志和节点资源。查询是探索式的,事先不知道要发多少条。发起这类查询的除了人,还有 agent;我们做过的 Agent RCA Bench 里一次 agent 调查平均三四十次工具调用,多的接近五十次。
长周期分析。容量规划、周报、成本归因,扫描几周到几个月的数据,单个查询重,但是频率低。
常见做法是前两类负载给监控栈(Prometheus + Loki + Tempo 或 ES),第三类负载再导一份数据到分析型数据库。这套架构让三类负载运行在同一份数据、同一套系统上。它不覆盖 APM 前端、on-call 排班和采集端的解析规则设计,这些仍由现有工具承担。
参考架构
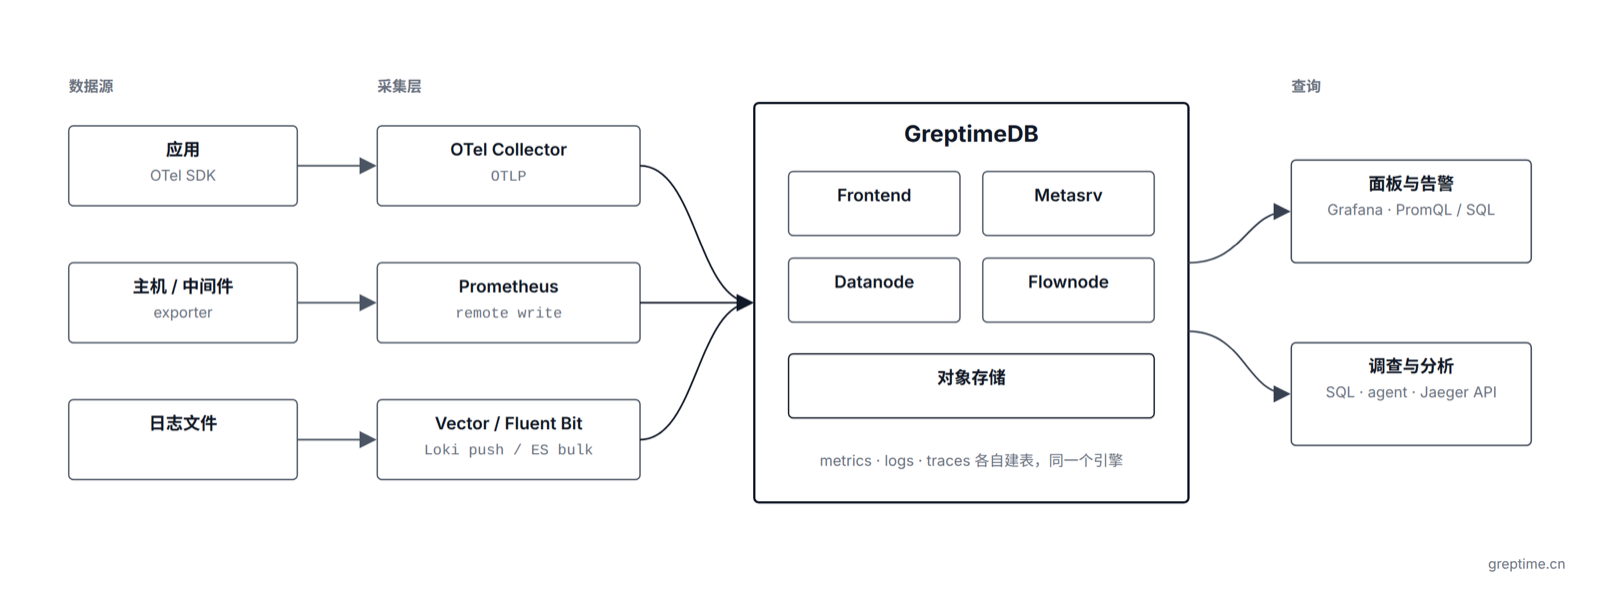
写入侧的原则是每种信号走它已有的协议,采集端不改。GreptimeDB 的写入端点按协议分开:
| 信号 | 协议 | 端点 | 落到哪里 |
|---|---|---|---|
| metrics | Prometheus remote write | /v1/prometheus/write | Metric Engine,每个 metric 一张逻辑表,共享物理表 |
| metrics / logs / traces | OTLP/HTTP | /v1/otlp/v1/{metrics,logs,traces} | metrics 按指标建表;logs 默认 opentelemetry_logs;traces 默认 opentelemetry_traces |
| logs | Loki Push API | /v1/loki/api/v1/push | 按 label 建表,可挂 pipeline 解析 |
| logs | Elasticsearch _bulk | /v1/elasticsearch/_bulk | index 映射为表 |
| logs / metrics | Vector 的 greptimedb_logs / greptimedb_metrics sink | HTTP 4000 / gRPC 4001 | 按 sink 配置建表 |
| logs / metrics / traces | Fluent Bit 的 HTTP 或 OpenTelemetry output | /v1/ingest、/v1/otlp/v1/*、/v1/prometheus/write | 按 output 配置建表 |
OTLP exporter 会自己补上信号路径,所以 Collector 里写到 /v1/otlp 即可;裸 HTTP 客户端要写完整路径。
查询侧有三个入口:SQL(MySQL 4002、PostgreSQL 4003、HTTP 4000)、PromQL HTTP API(/v1/prometheus/api/v1/query 与 query_range)、Jaeger 兼容 API(/v1/jaeger)。Grafana 通过 GreptimeDB 数据源插件、Prometheus 数据源或 MySQL 数据源接入,三种可以并存。
demo 在我本机运行 2 小时 16 分钟之后,库里有 860 张表:
- OTLP 进来的
opentelemetry_traces、opentelemetry_logs和两张 trace 辅助表; - 375 张应用与容器指标表(
http_server_request_duration_seconds_bucket、container_memory_usage_total_bytes、jvm_*、dotnet_*等,OTLP metrics); - 264 张
node_*和 217 张greptime_*,来自 node_exporter 和 GreptimeDB 自身的/metrics,经 Prometheus 抓取后 remote write 写入。
全库磁盘 154 MB。
需要你做的决定
采集器
选项有三个:OTel Collector 统一采集三种信号;保留现有 Prometheus 或 Alloy 做 metrics、另用 Vector 或 Fluent Bit 收日志;应用 SDK 直接写 GreptimeDB。
我们建议 OTel Collector 作为主采集器,三种信号各配一个 exporter 指向同一个 /v1/otlp 端点,traces 的 exporter 带 x-greptime-pipeline-name: greptime_trace_v1 头。三种信号从同一个 Collector 出来,resource attribute(service.name、k8s.pod.name 等)在三张表里一致,跨信号关联靠这些字段。已有 Prometheus 抓取体系的,remote write 直接指向 GreptimeDB,不必为了统一而改动 exporter。Vector 没有 traces sink,只用它收日志。
demo 的 Collector 配置:
yaml
exporters:
  otlphttp/traces:
    endpoint: http://greptimedb:4000/v1/otlp
    headers:
      x-greptime-pipeline-name: greptime_trace_v1
      x-greptime-hints: ttl=7d
  otlphttp/logs:
    endpoint: http://greptimedb:4000/v1/otlp
  otlphttp/metrics:
    endpoint: http://greptimedb:4000/v1/otlp
三个 exporter 分开配置,因为 GreptimeDB 用请求头区分信号的处理方式(traces 的 pipeline、logs 的表名和 pipeline),合在一起没法分别设置。x-greptime-hints: ttl=7d 让 trace 表在建表时带上 7 天 TTL。
同一个指标建议只走一条路。demo 的 Collector 基础配置带 host_metrics 和 prometheus/ad 两个 receiver(ad 服务自带 Prometheus 格式的 /metrics),我们把它们去掉,主机指标和 ad 指标统一交给 Prometheus 抓取再 remote write;主要是因为同一个 Prometheus 格式指标既走 OTLP 又走 remote write 会在写入时报时间戳类型冲突。
表怎么划分
每种信号建自己的表。GreptimeDB 对三种信号用同一套列语义(Tag、Timestamp、Field)和同一个列存引擎,schema、索引、TTL 和 append-only 设置按表各自定。
我们的建议是按信号分表,按体量分区:
- metrics 走 Metric Engine。Prometheus remote write 写进来会自动建逻辑表,多张逻辑表共享一张物理宽表,压缩和写入吞吐都比每个 metric 单独一张表好。
- logs 用 append-only 表,按查询需求选索引:等值过滤多的字段建倒排索引,
trace_id这类高基数但只做点查的字段用跳数索引,需要关键字检索的 body 字段建全文索引。文本日志在写入时用 pipeline 解析成列,查询时不再做现场解析。 - traces 用
greptime_trace_v1pipeline 的默认表结构,每行一个 span,service_name是 Tag,attribute 自动展平成列。 - wide events(一次请求一条宽记录,几十上百个字段)建议单独建表,适当设计主键和索引。
其中三张主要的表:
| 表 | 来源 | 列 | 行 | 磁盘 |
|---|---|---|---|---|
opentelemetry_traces | OTLP traces,greptime_trace_v1 | 193 | 867,803 | 98 MB |
opentelemetry_logs | OTLP logs | 14 | 249,098 | 30 MB |
greptime_physical_table | Prometheus remote write,481 张逻辑表共享 | 163 | 4,307,330 | 23 MB |
traces 表的 193 列来自属性展平,resource_attributes.service.namespace、span_attributes.http.request.body.size 这类列名由此而来,14 个服务用了多少种属性,表就有多少列。logs 表保持 OTLP 默认的 14 列,resource attribute 留在 resource_attributes 这个 JSON 列里,查询用 json_get_string(resource_attributes, '["service.name"]') 取服务名。SHOW CREATE TABLE node_cpu_seconds_total 能看到 ENGINE=metric 和 on_physical_table = 'greptime_physical_table',264 张 node_* 和 217 张 greptime_* 逻辑表都在这张物理表上。
展平成列和留在 JSON 里各有代价。前者可以直接建索引和按列过滤,代价是 schema 随属性增长,SDK 之间的类型差异会在写入侧暴露:demo 的 quote 服务是 PHP,SDK 把 http.request.body.size 写成字符串,长度未知时写空字符串,其他 SDK 写整数,GreptimeDB 按整数建了列,空字符串到达时整条 span 被拒收,Collector 日志里是 Partial success response 和 dropped_spans;解决办法是在 Collector 里加一个 transform processor 把数字字符串转成整数、空字符串删掉,问题消失。留在 JSON 里 schema 稳定,代价是每次取属性要解析 JSON。GreptimeDB v1.2.0 推出了 JSON2 类型,我们将基于它推出 v2 版本的 trace pipeline,减少解析 JSON 的开销。
分表还是分区的判断标准:数据在逻辑上不同(表结构不同、保留期不同)就分表;一张表大到单个节点承载不了才分区。集群模式下有一处容易漏掉:Metric Engine 默认的物理表只有一个分区,所有 remote write 写入同一个 datanode。因此,要么你在写入之前提前按 namespace 之类的 label 自建分区物理表,要么可以在运行时执行重分区。
热路径怎么隔离
面板和告警是这套系统里对延迟最敏感的负载,调查和分析里的一条重查询扫描的数据量大得多。两类负载共享一套系统,需要在两个层面隔离。
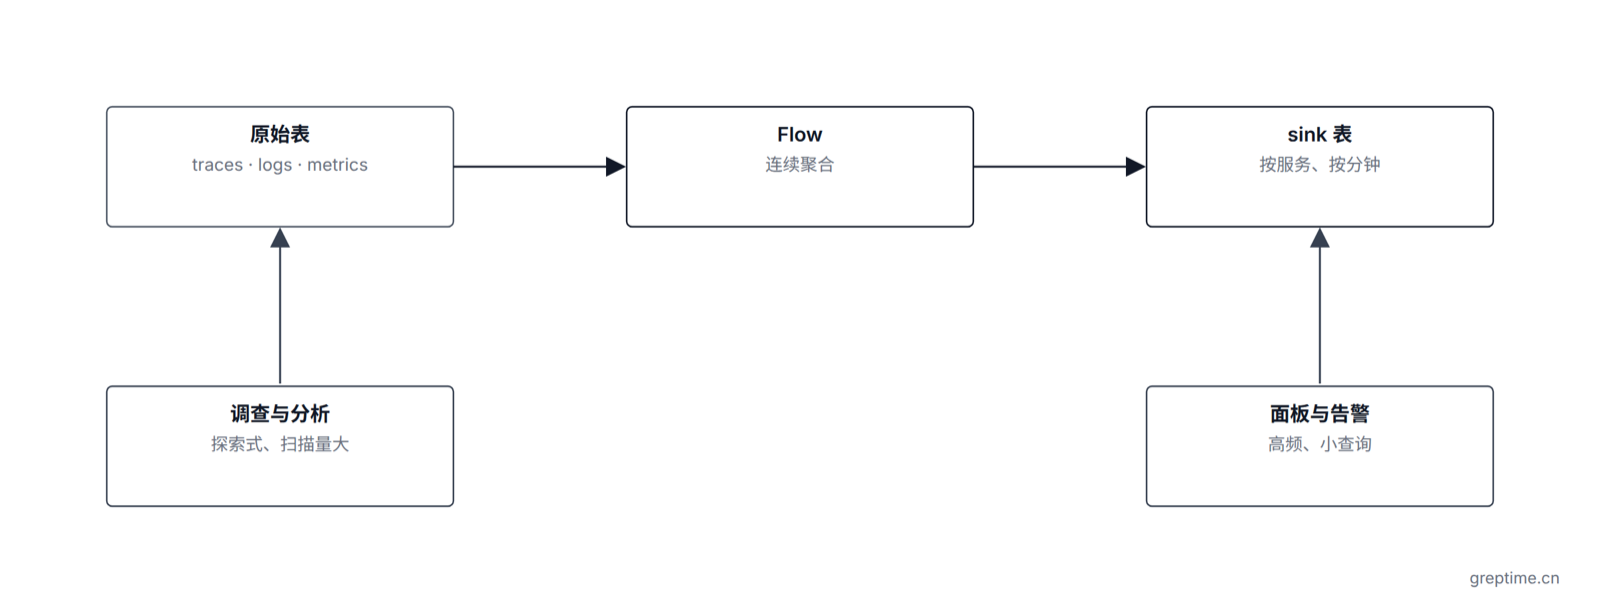
数据层面的 Flow 本质上是物化视图:一个固定的聚合,随数据写入持续更新。判据也和物化视图一样——查询固定且反复跑(面板、告警规则),并且至少满足一条:背后的明细扫描已经变贵;明细的 TTL 很短而聚合要留更久;或者这个数在明细表里根本没有,只能算出来,比如从 span 算每个服务的错误率。规模不大时这几条都不成立:面板查 Metric Engine 本来就快,demo 两小时的 traces 也就 86 万行、98 MB。下面这个 Flow 同时占了后两条——它从 span 算指标,而且能活过 trace 表 7 天的 TTL。
Flow 按固定间隔算出聚合写进 sink 表,面板和告警改读 sink 表,扫描原始表的只有调查和分析。得物的案例里,Flow 维护 10 秒、1 分钟、10 分钟三档 rollup,面板查询的 P99 从秒级降到毫秒级。告警规则同理:先用 Flow 算出每个服务每分钟的错误数,Grafana 的告警只需要对一张小表做一次比较。demo 的 Flow:
sql
CREATE FLOW IF NOT EXISTS service_error_rate_1m
SINK TO service_error_rate_1m
EVAL INTERVAL '30s'
AS
SELECT
  service_name,
  date_bin('1 minute'::INTERVAL, "timestamp") AS time_window,
  count(*) AS total,
  sum(CASE WHEN span_status_code = 'STATUS_CODE_ERROR' THEN 1 ELSE 0 END) AS errors
FROM opentelemetry_traces
WHERE span_kind = 'SPAN_KIND_SERVER'
  AND "resource_attributes.service.namespace" = 'opentelemetry-demo'
GROUP BY service_name, time_window;
sink 表由 Flow 自动建出,service_name 是主键,time_window 是时间索引。两小时的数据在 sink 表里 2,485 行、60 KB,原始 traces 表 86 万行。sink 表里 checkout 和 payment 两个服务在一次故障前后六个分钟窗口的行(故障过程见后文):
sql
SELECT service_name, time_window, total, errors
FROM service_error_rate_1m
WHERE service_name IN ('checkout', 'payment')
  AND time_window BETWEEN '2026-09-15 14:42:00' AND '2026-09-15 14:47:00'
ORDER BY time_window, service_name;| service_name | time_window | total | errors |
|---|---|---|---|
| checkout | 14:42 | 2 | 0 |
| payment | 14:42 | 2 | 0 |
| checkout | 14:43 | 7 | 5 |
| payment | 14:43 | 7 | 5 |
| checkout | 14:44 | 2 | 2 |
| payment | 14:44 | 2 | 2 |
| checkout | 14:45 | 4 | 2 |
| payment | 14:45 | 3 | 2 |
| checkout | 14:46 | 1 | 0 |
| payment | 14:46 | 1 | 0 |
| checkout | 14:47 | 1 | 0 |
| payment | 14:47 | 2 | 0 |
告警规则对这张表做窗口查询,每次扫描的是几千行。
节点层面用 frontend group。GreptimeDB 集群可以配多组 frontend,Helm chart 里可以给 read 和 write 两组各自设置副本数和资源限制,面板、告警和采集器分别指向不同的 service。这一层隔离的是查询规划和协议处理的资源,datanode 仍然是共享的。要把重查询的存储层扫描也隔离出去,需要企业版的 Read Replica(只读 datanode)或 Datanode groups,欢迎联系我们获取 demo。
保留期与存储
对象存储是这套架构的默认选择:GreptimeDB 落盘数据大约是原始输入的 1/8 到 1/10,长周期分析要保留几个月,放对象存储比放本地盘便宜,扩容也不需要在 datanode 之间复制数据文件。本地盘只承担查询缓存和 WAL,起步 200 GB,实际按磁盘空间、缓存配置和 WAL 保留量定。
TTL 按表设置,表级优先于库级。metrics 与 Flow 的 sink 表保留 90 天以上,traces 7 到 14 天,原始 logs 按合规要求定,wide events 按体积定。这几个数字按你的查询习惯调;sink 表的保留期要长于原始表,长周期分析经常都在查聚合结果。
WAL 有 Local 和 Remote 两种。Local WAL 用 datanode 自带的 raft-engine,不需要额外组件,datanode 重启要回放 WAL,恢复时间取决于需要重放的数据大小(即未刷写到持久存储的 memtable 数据大小);Remote WAL 用 Kafka,datanode 故障后 Metasrv 可以直接把 region 切换到其他节点,灾难恢复时间短,代价是多运维一个 Kafka。单机和小集群用 Local WAL,对高可用性要求的集群建议用 Remote WAL。
查询面给谁用
三个查询入口对应三类使用者。
PromQL 给 DevOps 和已有的 Grafana 面板。GreptimeDB 的 PromQL HTTP API 与 Prometheus 兼容,现有面板把数据源指向 GreptimeDB 就能用,告警规则用 Grafana 原生 alerting 评估。demo 的主机面板全部是 Prometheus 数据源上的标准表达式,1 - avg(rate(node_cpu_seconds_total{job="node",mode="idle"}[5m])) 这类写法和 Grafana 社区面板一致,数据源换成 GreptimeDB 之后表达式没有改动。
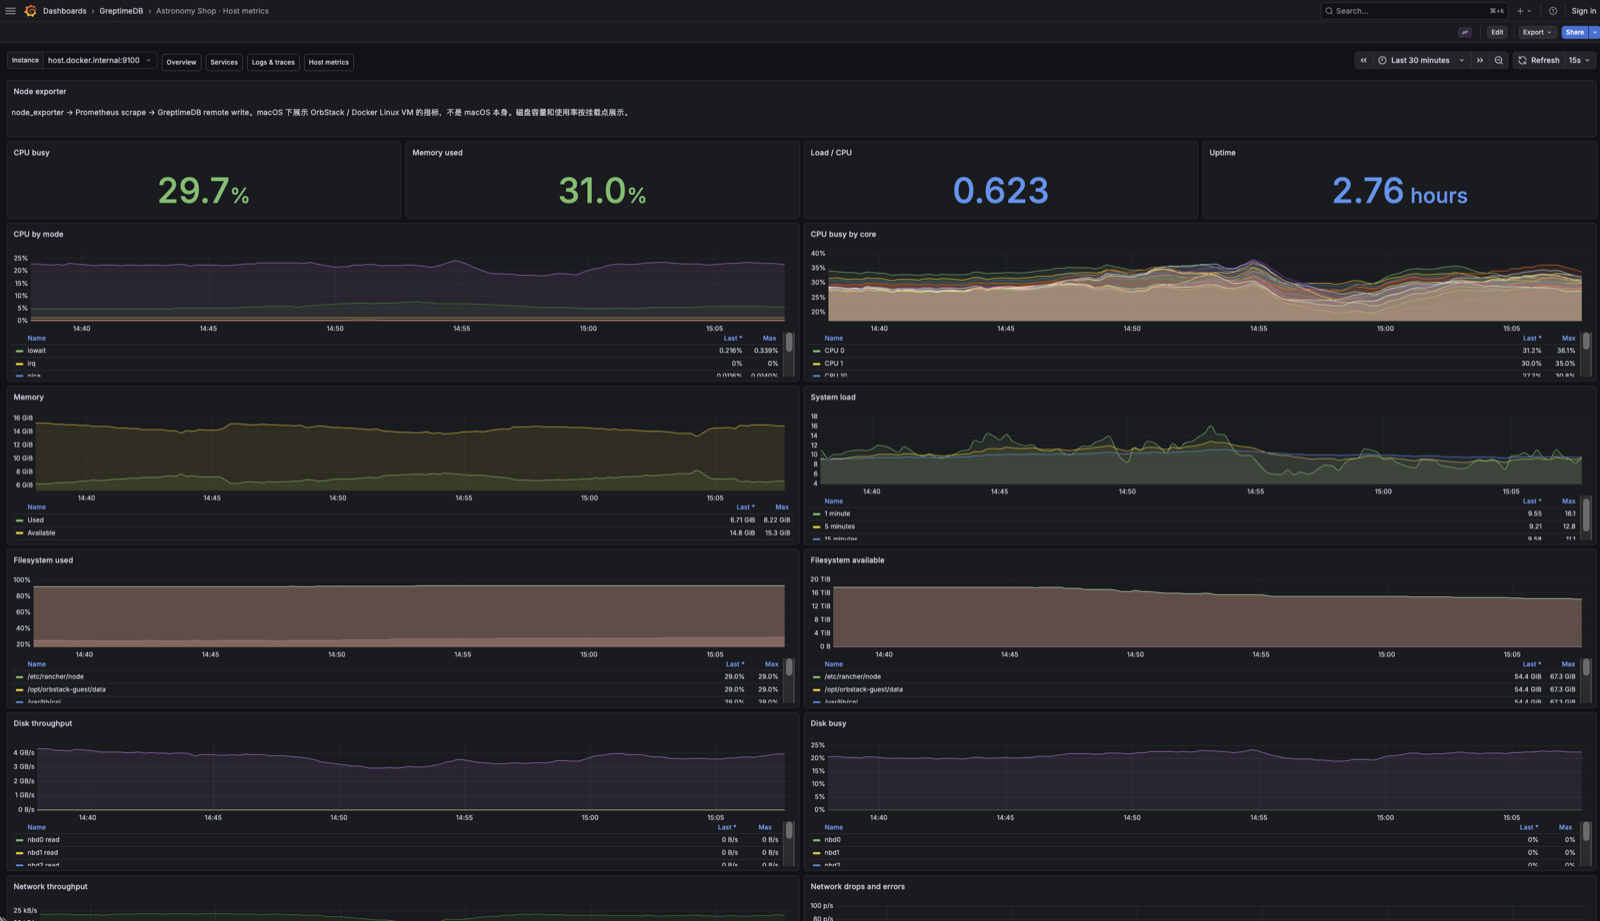
SQL 给调查、分析和 agent。Grafana 的 GreptimeDB 数据源插件提供 SQL 查询和 Logs、Traces 两种查询类型,带 OpenTelemetry 预设的列映射。Notebook、BI 工具和 agent 走 MySQL 或 PostgreSQL 协议。我们也提供了 GreptimeDB MCP Server,可以让 LLM 和 GreptimeDB 直接交互。
Jaeger 兼容 API 给现有的 trace 查看工具,/v1/jaeger 下提供 /api/services、/api/traces、/api/traces/{trace_id},Grafana 的 Jaeger 数据源可以直接指向这个地址,或者继续使用 Jaeger 自带的 UI。
一次调查在一个数据库里长什么样
统一到一个查询面之后,跨信号关联是同一个 trace_id 上的几次查询。两个例子都取自 demo 的实际记录。
demo 自带故障开关。把 paymentFailure 设为 100% 之后,checkout 请求返回 HTTP 422。上一节 sink 表里 14:43 到 14:45 三个窗口的 errors 就是这次故障,Overview 的错误率曲线在这三分钟出现尖峰。从 sink 表回到原始表,先取出错的服务端 span:
sql
SELECT "timestamp", service_name, span_name, duration_nano / 1e6 AS ms, trace_id
FROM opentelemetry_traces
WHERE span_kind = 'SPAN_KIND_SERVER'
  AND span_status_code = 'STATUS_CODE_ERROR'
  AND service_name IN ('checkout', 'payment')
ORDER BY "timestamp" DESC
LIMIT 6;| timestamp | service_name | span_name | ms | trace_id |
|---|---|---|---|---|
| 14:45:29.778 | payment | oteldemo.PaymentService/Charge | 0.5 | 292a59a2… |
| 14:45:25.556 | checkout | oteldemo.CheckoutService/PlaceOrder | 4242.7 | 292a59a2… |
| 14:45:08.962 | payment | oteldemo.PaymentService/Charge | 0.5 | 8f17e37c… |
| 14:45:05.719 | checkout | oteldemo.CheckoutService/PlaceOrder | 3374.1 | 8f17e37c… |
| 14:44:13.247 | payment | oteldemo.PaymentService/Charge | 0.4 | de318fc3… |
| 14:44:09.866 | checkout | oteldemo.CheckoutService/PlaceOrder | 3454.4 | de318fc3… |
每对错误 span 共享一个 trace_id。取第一个 trace_id 查询整条调用链,只列 CLIENT 和 SERVER 两类 span:
| service | span | kind | ms | status |
|---|---|---|---|---|
| frontend-proxy | POST | SERVER | 4396.8 | UNSET |
| frontend | POST /api/checkout | SERVER | 4396.8 | UNSET |
| checkout | oteldemo.CheckoutService/PlaceOrder | SERVER | 4242.7 | ERROR |
| checkout | oteldemo.PaymentService/Charge | CLIENT | 48.4 | ERROR |
| payment | oteldemo.PaymentService/Charge | SERVER | 0.5 | ERROR |
checkout 的 span_status_message:failed to charge card: could not charge the card: rpc error: code = Unknown desc = Payment request failed. Invalid token.。同一个 trace_id 查询 opentelemetry_logs,这条调用链上有几十条日志,与故障相关的几条:
sql
SELECT "timestamp", json_get_string(resource_attributes, '["service.name"]') AS service, severity_text, body
FROM opentelemetry_logs
WHERE trace_id = '292a59a2b413877ef2392a28d1e52c87'
ORDER BY "timestamp";| timestamp | service | severity | body |
|---|---|---|---|
| 14:45:25.421 | frontend-proxy | "POST /api/checkout HTTP/1.1" 422 … 4396 4396 | |
| 14:45:25.651 | checkout | INFO | [PlaceOrder] |
| 14:45:29.307 | shipping | INFO | Requesting quote |
| 14:45:29.778 | payment | info | Charge request received. |
| 14:45:29.778 | payment | warn | Payment request failed. Invalid token. demo.user_context.loyalty_level=gold |
| 14:45:29.817 | frontend | info | Checkout payment declined |
这条日志在 payment 服务里是 warn 级别,对应的 span 是 ERROR,两边的级别由各自的应用代码决定。
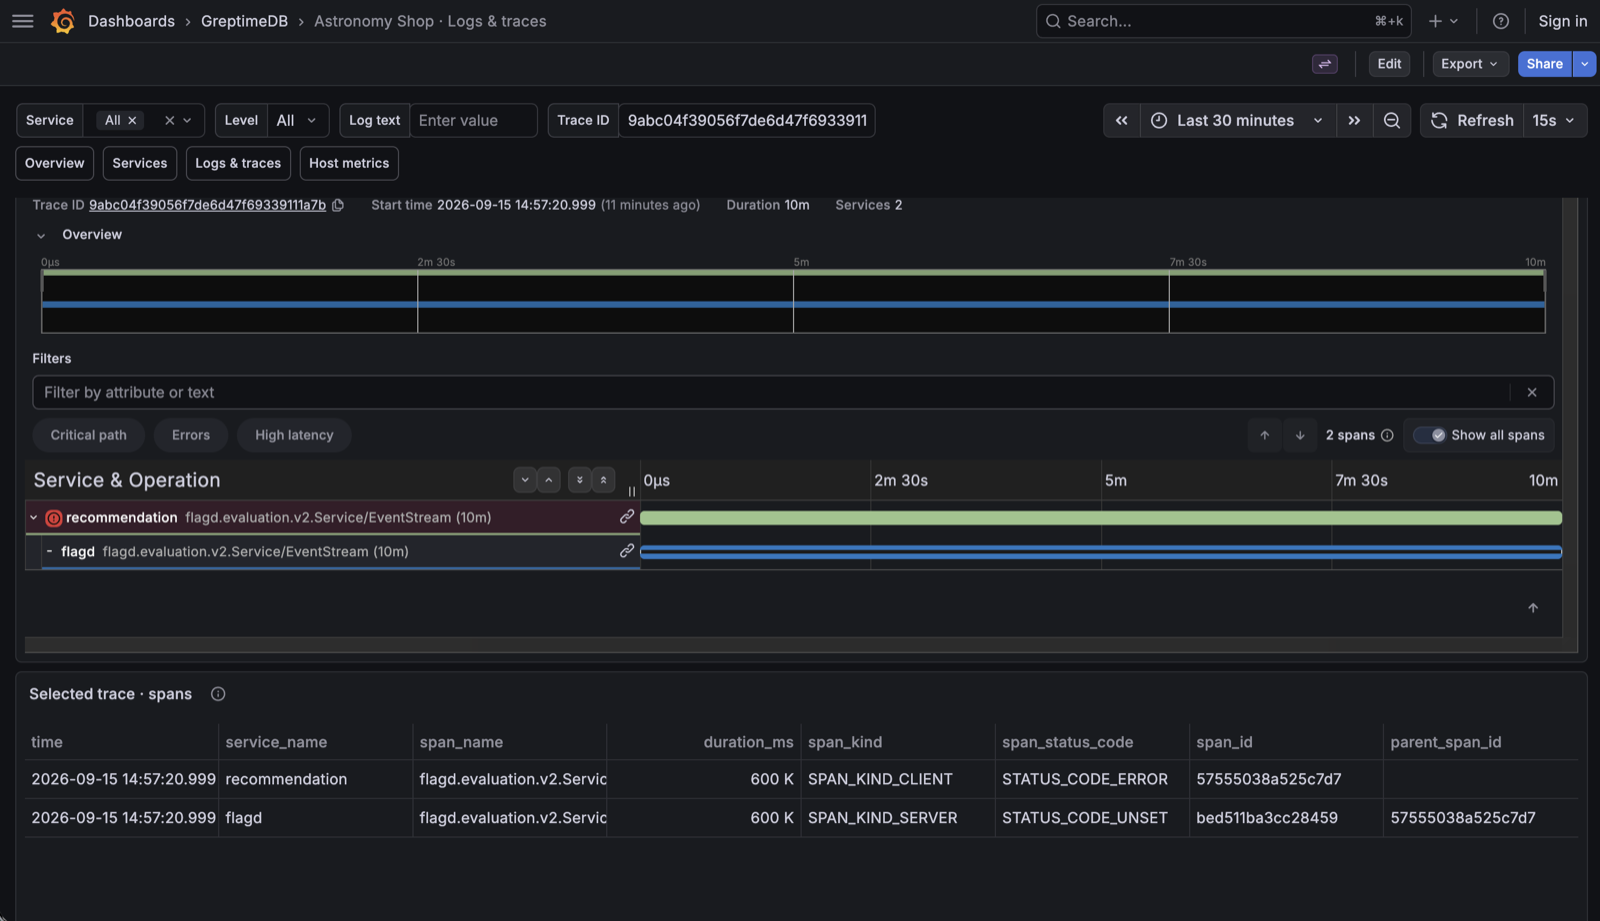
延迟问题用一次 self-join。opentelemetry_traces 表里每行一个 span,同一次调用的客户端 span 和服务端 span 通过 trace_id 与 parent_span_id 关联,把两边的耗时放在同一行:
sql
SELECT
  c.trace_id,
  c.service_name        AS client,
  s.service_name        AS server,
  s.span_name,
  c.duration_nano / 1e6 AS client_ms,
  s.duration_nano / 1e6 AS server_ms
FROM opentelemetry_traces c
JOIN opentelemetry_traces s
  ON s.trace_id = c.trace_id
 AND s.parent_span_id = c.span_id
WHERE c.span_kind = 'SPAN_KIND_CLIENT'
  AND s.span_kind = 'SPAN_KIND_SERVER'
  AND c."timestamp" > now() - INTERVAL '30 minutes'
ORDER BY client_ms DESC
LIMIT 30;
demo 里一次 10 秒的 checkout 请求,trace 8ea79526…,限定这个 trace_id 之后,入口调用和 checkout 发出的调用:
| client | server | span_name | client_ms | server_ms |
|---|---|---|---|---|
| frontend | checkout | oteldemo.CheckoutService/PlaceOrder | 9315.9 | 9226.3 |
| checkout | product-catalog | oteldemo.ProductCatalogService/GetProduct | 1650.1 | 1161.0 |
| checkout | product-catalog | oteldemo.ProductCatalogService/GetProduct | 1181.0 | 768.2 |
| checkout | product-catalog | oteldemo.ProductCatalogService/GetProduct | 815.5 | 452.5 |
| checkout | product-catalog | oteldemo.ProductCatalogService/GetProduct | 627.5 | 272.6 |
| checkout | shipping | POST /get-quote | 490.9 | 4.3 |
| checkout | currency | oteldemo.CurrencyService/Convert | 423.0 | 0.02 |
| checkout | currency | oteldemo.CurrencyService/Convert | 372.5 | 0.03 |
| checkout | payment | oteldemo.PaymentService/Charge | 339.7 | 0.57 |
| checkout | currency | oteldemo.CurrencyService/Convert | 304.0 | 0.03 |
| checkout | shipping | POST /ship-order | 251.3 | 0.72 |
| checkout | currency | oteldemo.CurrencyService/Convert | 219.0 | 0.03 |
| checkout | cart | POST /oteldemo.CartService/GetCart | 202.7 | 5.53 |
| checkout | POST /send_order_confirmation | 186.8 | 18.36 | |
| checkout | currency | oteldemo.CurrencyService/Convert | 121.9 | 0.03 |
GetProduct 的客户端和服务端耗时在同一量级;Convert、Charge、get-quote 这几类调用服务端处理不到 1 ms,客户端等待 120 到 490 ms,差值出现在 checkout 到这些服务之间的调用路径上。原因要在应用和网络层面查,这张表给出的是差值所在的位置。
Agent RCA Bench 测量过查询接口对 agent 调查的影响。六个模型、14 个事故、每个重复两次,每组接口 168 次端到端调查,比较 Prometheus、Loki、Tempo 三套原生 API 和 GreptimeDB 的只读 SQL 与 PromQL。同样的模型、prompt 和原始数据,GreptimeDB 接口下正确诊断 130 次,三套接口下 105 次;读入的 input token 少 48%;按模型 API 计价的估算成本低约 45%。六个模型在 GreptimeDB 接口下读入的 token 都更少,其中五个诊断更准。这个比较改变的是整个接口组合,存储、查询语言和工具设计一起变了,单独的存储引擎差异没有从中剥离出来。GreptimeDB 接口下的调查里跨信号 JOIN 只出现过 3 次,模型更多做的是上面这种同一张表内的配对和按时间窗口的对比。完整的协议、逐次运行的记录和每个结论的适用范围在评测报告里。
三个规模档位
单机
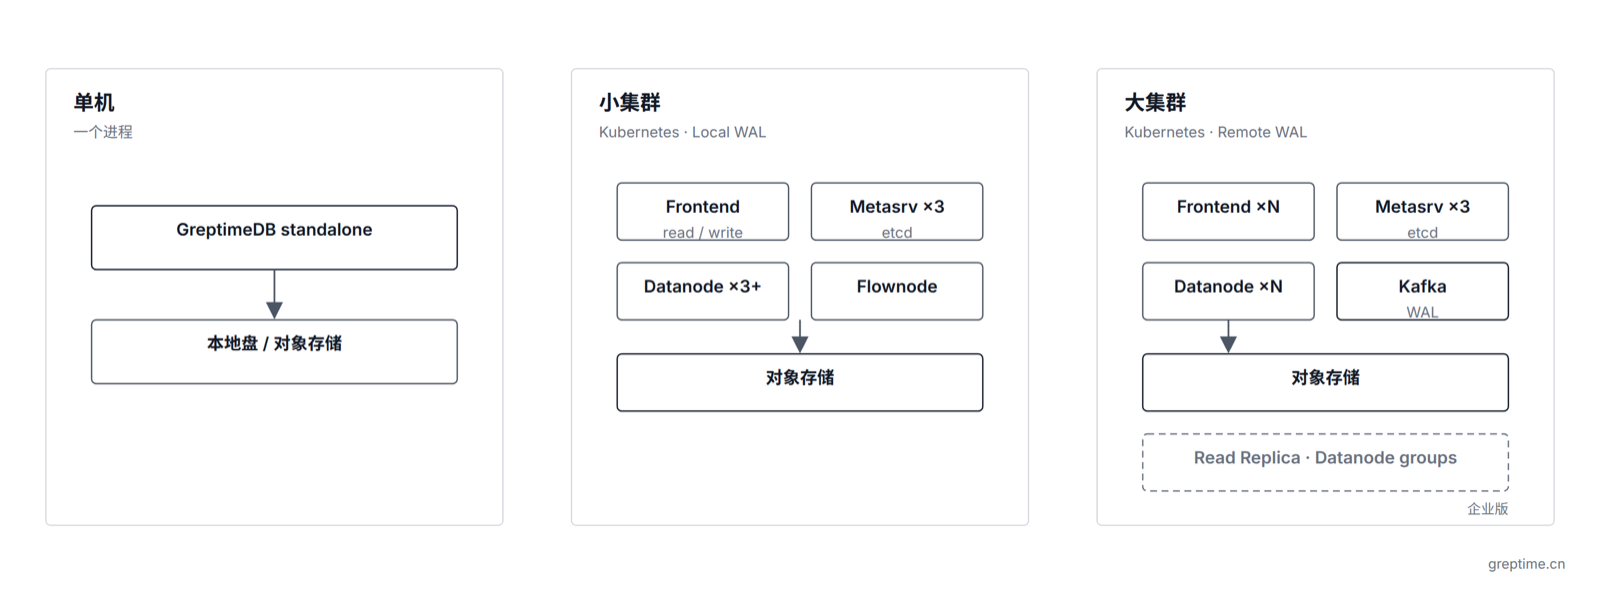
一个 GreptimeDB 进程提供全部功能,容器或二进制都行,数据放本地盘或对象存储。适合一个团队、一个 Kubernetes 命名空间或一套 staging 环境,demo 运行的就是这一档。
起步 8 核 32 GB 内存加 200 GB 本地盘,对应每秒约 30 万数据点写入和 200 QPS 的简单查询;能否达到取决于 schema、行宽、索引和查询的时间范围,请用实际的负载验证。CPU 与内存按 1:4 配,写入占用大约 30% 的 CPU。
这一档通常不需要 Flow。等面板查询变慢再加,Flow 的定义在单机和集群上是一样的,升级时不用重写。
小集群
Kubernetes 上用 GreptimeDB Operator 和 Helm chart 部署,组件包括 Metasrv、Frontend、Datanode、Flownode,元数据存 etcd 或 MySQL / PostgreSQL,数据文件放对象存储。生产起步的形态是 Metasrv 与 etcd 各三副本,Frontend 分 read、write 两组,Datanode 三个以上,Flownode 一个,Local WAL。
这个架构要做两件单机不需要做的事。Metric Engine 的物理表要按 label 分区,否则所有 remote write 写入同一个 datanode;大表(logs、traces、wide events)按 service_name 或 namespace 之类的高选择性列分区;opentelemetry_traces 已经内置了按 trace_id 的分区规则,默认 16 个分区。Collector 配置、remote write 地址、Flow 定义和 Grafana 面板沿用单机的,不用改。注意,不启用 remote WAL 的情况下,这个集群的高可用仍然需要依赖 Kubernetes 的 pod 调度,本地磁盘建议启用 PVC 挂载。
大集群
写入量和查询并发再上一个量级之后,变化在三处。WAL 建议换成 Remote WAL,datanode 故障时 region 直接切换到其他节点,不需要本地回放。Datanode 按分区数横向扩展,Frontend 按查询并发横向扩展,两者独立。对象存储的容量不再是设计约束,OceanBase Cloud 的案例里 80 多个集群保留 7 天、300 TB 的日志和 SQL 审计数据,写入约 1 GB/s。
运行时调整索引、数据重分区、Region 迁移在开源版里都能做,手动操作。
你也可以选择开源版之外的能力:只读 datanode(Read Replica)把分析型重查询的扫描从写入路径上分出去,Datanode groups 做负载隔离,Autopilot 用 Region 自动均衡和自动重分区处理数据倾斜。这些在企业版里。
三条迁移路径
迁移通常按信号逐个进行,每条路径的节奏相同:先双写,再切读,最后下线旧系统。
从 Prometheus 迁移改动最少。Prometheus 的 remote_write 加一个指向 GreptimeDB 的目标,双写一段时间后把 Grafana 的 Prometheus 数据源指向 GreptimeDB 的 PromQL 端点,面板和告警规则不用改。切读完成之后再决定是否保留 Prometheus 做本地抓取;demo 里 Prometheus 保留抓取,本地 TSDB 只留 2 小时。细节见从 Prometheus 迁移;生产环境上切换的过程,有用户写过从 Thanos 迁移的记录。需要注意,Metric Engine 默认不为 label 列建索引,要根据实际查询负载为物理表开启跳数索引(index.type = 'skipping'),或在运行时为具体列创建倒排、跳数或全文索引,这对查询性能影响很大。
从 Loki 迁移的写入侧同样是加一个目标:Promtail、Alloy 或 Vector 的 Loki client 增加 /v1/loki/api/v1/push 端点,客户端不用换。读侧要提前知道:GreptimeDB 提供 Loki 的写入协议,不提供 LogQL,日志查询改用 SQL 或 Grafana 的 GreptimeDB 数据源插件。原来在 LogQL 里用管道解析的字段,迁移时改成写入侧的 pipeline 解析成列。从 Loki 迁移的文档包含双写配置、验证数据模型和迁移历史日志的步骤;我们把这个流程完整跑过一遍,配置都写在里面。
从 Elasticsearch 和 Jaeger 迁移分两半。日志侧 Logstash、Filebeat 的 output 指向 /v1/elasticsearch,同时关掉 template、ILM 和 data stream 管理,开源版只实现 _bulk 写入,不实现 Query DSL;Kibana 继续用需要企业版的 Elasticsearch 查询兼容。trace 侧应用的 OTLP exporter 直接指向 GreptimeDB,Jaeger UI 或 Grafana 的 Jaeger 数据源指向 /v1/jaeger。span 落到的表结构见这里。
边界与取舍
亚毫秒级的 metrics 热查询,VictoriaMetrics 更快,我们在这一项上不占优势。如果负载只有 metrics,而且面板刷新延迟是首要指标,单独的 VictoriaMetrics 是合理的选择。这套架构的收益在三类负载共用一份数据和一个查询面。
Loki 兼容只到写入协议,Elasticsearch 兼容在开源版只到 _bulk。两者的读侧都要换成 SQL。
开源版和企业版的边界在这篇文章里涉及的部分:单机与集群部署、对象存储、SQL 与 PromQL、Flow、索引、frontend group 以及上面列出的全部写入接口在开源版里;Read Replica、Datanode groups、Region 自动均衡与重分区、RBAC 与 LDAP、审计日志、Active-Active 容灾、Elasticsearch 查询兼容、Trigger(兼容 Alertmanager 的告警评估)在企业版里。开源版的告警走 Grafana alerting。完整的边界以 pricing 页为准。
从 demo 开始
greptimedb-observability-playground 仓库在 opentelemetry-demo 之上叠两个文件:compose.greptime.yaml 加 GreptimeDB、node_exporter、Prometheus、建 Flow 的 init 容器和预装数据源插件的 Grafana,otelcol-config-greptime.yml 替换 Collector 的 exporter。上游文件不改。python3 demo.py up 启动后,Grafana 里有 Overview、Services、Logs & traces、Host metrics 四块面板,本文的 Flow、跨信号 SQL 和 self-join 都在面板里。集群部署请参考 Kubernetes 部署文档,Flow 定义和 Grafana 面板直接沿用。
我们还提供了给 Agent 用的 Skill,部署和查询可以交给 Agent 来操作。
参考资料
- GreptimeDB 文档:架构、为什么选择 GreptimeDB、容量规划、表设计、WAL
- 写入:OpenTelemetry、OTel Collector、Prometheus remote write、Loki、Elasticsearch、Vector
- 查询与集成:PromQL、Jaeger 兼容 API、Grafana、Traces、Flow
- 部署:Kubernetes 部署、Frontend groups、企业版功能、开源版与企业版边界
- 迁移文档:从 Prometheus 迁移、从 Loki 迁移
- 迁移实践:Scale Prometheus、从 Thanos 到 GreptimeDB、从 Loki 双写迁移、从 InfluxDB 迁移
- Agent RCA Bench:六模型报告、代码与产物
- 案例:得物、OceanBase Cloud
- 验证环境:OpenTelemetry Demo、greptimedb-observability-playground、GreptimeDB MCP Server、GreptimeDB Agent Skill
- 前文:可观测性已经开始统一,但查询它的不再只是人


