本页内容

Remote WAL
目前 GreptimeDB 的 WAL 基于本地存储,不具备完全的容灾能力。一个分布式的(Remote)WAL 是 GreptimeDB 实现 Region Migration 、 Region Rebalance 、RegionSplit/Merge 等这些高阶分布式功能的基础,这些功能也是实现水平扩展和数据热点拆分的关键特性。
对于第一个 Remote WAL 版本,造一个新轮子不是我们的目标,权衡再三我们认为基于Kafka 来构建我们第一个 Remote WAL 存储服务是比较合适的。**Kafka 给用户提供pub/sub topic 的接口,每个 topic 会绑定-个 message stream。**messages 被划分到文件系统上的多个目录,每个目录称为一个 partition。每个目录里面维护了若干个 segment 文件。向某个 topic 写入一个 message,即向该 topic 某个 partition 的最新的 segment 文件的末尾 append 这条 message。这种 append-only 的写入方式使得 Kafka 的写入性能很高,这是我们采用 Kafka 作为 Remote WAL 存储服务所考虑的主要因素之一。对于 Kafkaclient,我们使用 rskafka,一个 Rust 实现的完全异步的客户端。
第一个 Remote WAL 实现,是 GreptimeDB 实现健壮的分布式能力的一个好的基础,在Remote WAL 的基础上,我们还会在近期发布 Region Migration 功能。
Metrics Engine
在可观测领域的时序数据库中,GreptimeDB 的设计侧重点与 Prometheus 或是 VictoriaMetrics 等时序数据库有一些区别,GreptimeDB 的表的概念是相对复杂和重量级的,需要占用较重的资源。这在需要创建海量小表的场景中让 GreptimeDB 默认引擎的表管理能力捉襟见肘。为了更高效地处理海量的小表,**我们在 0.5 版本中引入了一个全新的引擎(Metrics Engine),它的主要目标是能处理大量的小表,特别适合像 Prometheus 指标那样的场景。**通过利用合成的宽表,这个新 engine 提供指标数据存储和元数据复用的能力,“表”在它之上变得更轻量,它克服了现有 Mito 引擎的表过于重量级的一些限制。
**对于 Metrics Engine,目标是解决监控场景下,大量小表所带来的资源开销,减小对大量表同时创建/写入场景下存在的固定延时等问题。**我们目前只是往最终目标迈出了坚实的一步,接下来还有很长的路要走,短期计划是进一步优化资源占用、优化创建表的速度,还会针对新引擎提高 PromQL 的查询性能。在接下来的每个版本升级中,预计大家都可以看到 Metrics Engine 的进步和完善。
其他模块重点更新
PromQL 兼容性提高到了 82%
PromQL 有不错的进展,兼容性提高到了 82%,支持了
histogram_quantile函数,对齐了linear_regression行为,也实现了 PromQL 的AND和UNLESS操作符。更多细节,可看这里。Mito Engine 持续优化
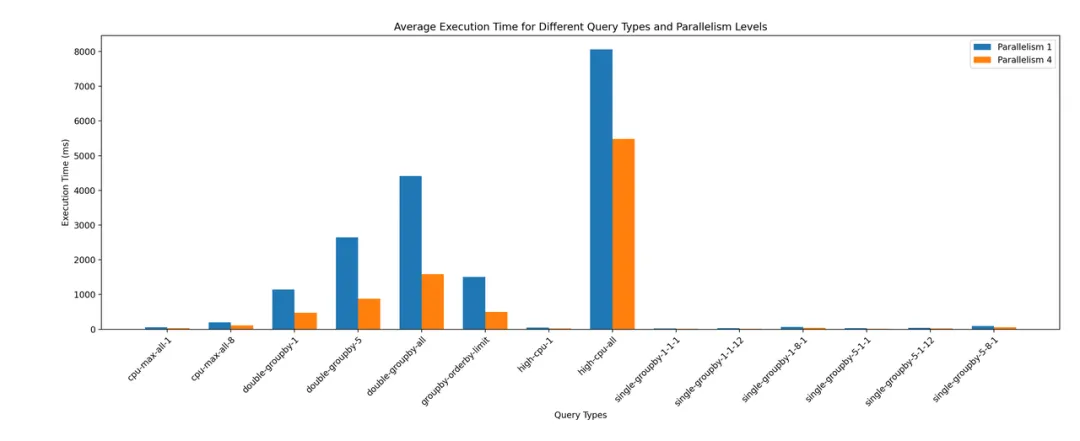
丰富 sqlness 测试场景;我们为 Mito 引入了一个 row group 级别的 page cache,经测试它可以为我们平均节省 20% ~ 30% 的扫描时间,我们还支持了并行扫描 SST 和 Memtable,这个优化使得 GreptimeDB 在 TSBS Benchmark 中扫描性能显著提升,部分场景提高达 200%。
其他亮点功能
支持在创建表时指定不同的存储后端
在以前,表只能存储在同一个存储后端中,现在 GreptimeDB 支持了在启动时配置多个不同的存储后端,并在建表时可以为表指定存储后端。举一个最简单的例子:我们可以将一张表存在本地,一张表存储在 S3 上。
支持嵌套的 Range 表达式
像
max(a+1) Range '5m' FILL NULL这样的 Range 表达式可以嵌套在任何表达式中,比如下面这个嵌套 Range 查询:
sql
Select
    round(max(a+1) Range '5m' FILL NULL),
    sin((max(a) + 1) Range '5m' FILL NULL),
from
    test
ALIGN '1h' by (b) FILL NULL;
该 SQL 查询在语义上等价于:
sql
Select round(x), sin(y + 1) from
    (
        select max(a+1) Range '5m' FILL NULL as x, max(a) Range '5m' FILL NULL as y
            from
        test
            ALIGN '1h' by (b) FILL NULL;
    )
;- 新增
ALIGN TO子句和Interval查询支持
Interval 表达式可以在 Range 和 ALIGN 关键字之后,作为可选的持续时间字符串替代:
sql
SELECT
    rate(a) RANGE (INTERVAL '1 year 2 hours 3 minutes')
FROM
    t
    ALIGN (INTERVAL '1 year 2 hours 3 minutes')
FILL NULL;
ALIGN TO 子句,用户可以使用 ALIGN TO 将时间对齐到他们想要的时间点。
sql
SELECT rate(a) RANGE '6m' FROM t ALIGN '1h' TO '2021-07-01 00:00:00' by (a, b) FILL NULL;可用的 ALIGN TO 选项包括:
不使用
ALIGN TO(默认):对齐到 UTC 时间戳 0;Now:对齐到当前 UTC 时间戳;
Timestamp:对齐到用户指定的特定时间戳。
未来展望
有了 Remote WAL 作为基础,接下来我们计划实现 Region 的 Migration,Region Migration 可以帮助我们实现负载平衡,我们会支持通过管控 API 手动触发的 Region Migration,进一步的会实现自动的负载平衡调度。
对于最基础的 Mito Engine(事实上 Metrics Engine 也构建于它之上),我们仍然会对其持续优化,逐步去提升它的查询性能,近期的重点是优化它与对象存储之间的各种数据传输的延迟。
还有一个会大幅提升部分场景查询的重大 feature,倒排索引特性也在路上了,我们预计会在一月底之前发布它,我们可以在这里看到它的最新进展。
关于 Greptime
Greptime 格睿科技专注于为可观测、物联网及车联网等领域提供实时、高效的数据存储和分析服务,帮助客户挖掘数据的深层价值。目前基于云原生的时序数据库 GreptimeDB 已经衍生出多款适合不同用户的解决方案,更多信息或 demo 展示请联系下方小助手(微信号:greptime)。
欢迎对开源感兴趣的朋友们参与贡献和讨论,从带有 good first issue 标签的 issue 开始你的开源之旅吧~期待在开源社群里遇见你!添加小助手微信即可加入“技术交流群”与志同道合的朋友们面对面交流哦~
Star us on GitHub Now: https://github.com/GreptimeTeam/greptimedb
Twitter: https://twitter.com/Greptime
Slack: https://greptime.com/slack


